데이터 탐구 프로젝트 수업에서의 데이터 리터러시 자기평가와 통계포스터 산출물 분석
Copyright ⓒ 2026 The Digital Contents Society
This is an Open Access article distributed under the terms of the Creative Commons Attribution Non-CommercialLicense(http://creativecommons.org/licenses/by-nc/3.0/) which permits unrestricted non-commercial use, distribution, and reproduction in any medium, provided the original work is properly cited.
초록
본 연구는 데이터 탐구 프로젝트 수업 이후 나타난 데이터 리터러시 자기평가 변화와 통계포스터형 산출물의 특징을 분석하였다. 파이썬 기초 학습 경험이 있는 중·고등학생 30명을 대상으로 12회기 수업을 운영하고, 사전·사후 자기평가 설문과 최종 산출물 30편을 분석하였다. 수업은 탐구주제 구체화, 공공데이터 및 자가수집 자료 확보, 파이썬 기반 분석·시각화, 통계포스터형 산출물 제작으로 구성하였다. 데이터 리터러시 자기평가에 대한 t-검정 결과, 통계적으로 유의한(p<0.01) 향상이 나타나 학습자의 데이터 리터리시에 대한 긍정적 인식 변화를 보여주었다. 통계포스터형 산출물은 기본 구조를 갖추었으나, 탐구문제와 자료의 연결성, 그래프 선택, 해석과 결론 제시 수준에서 차이가 나타났다. 사후 자기평가 총점과 산출물 평가 총점 간에는 유의한 정적 상관을 보였으나, 하위 항목에서 일관되게 유의한 결과를 나타내지는 않았다. 이는 데이터 탐구 수업의 결과를 자기평가 변화와 산출물에 나타난 수행 특징이라는 두 측면에서 검토할 필요가 있음을 보여준다.
Abstract
This study analyzed changes in self-assessed data literacy and the characteristics of statistical poster-type outputs following a data-inquiry project class. Participants were 30 middle- and high-school students with basic Python experience. A 12-session class focused on inquiry topic refinement, data collection, Python-based analysis and visualization, and poster-type output production. Data were collected from pre- and post-test self-assessment questionnaires and 30 final outputs. A t-test on data literacy showed a statistically significant improvement (p < 0.01), demonstrating a positive change in learners’ perceptions of data literacy. The statistical poster-type outputs possessed a basic structure, but differences were observed in the connectivity between the inquiry question and data, graph selection, and level of interpretation and conclusion presentation. A significant positive correlation was observed between the total post-test self-assessment score and the total output evaluation score, but consistently significant results were not shown for each sub-item. These findings suggest that data-inquiry learning outcomes should be examined through both self-assessment changes and output characteristics.
Keywords:
Data Literacy, Data Inquiry, Project Class, Statistical Poster-Type Output, Data Visualization키워드:
데이터 리터러시, 데이터 탐구, 프로젝트 수업, 통계포스터형 산출물, 데이터 시각화Ⅰ. 서 론
디지털 전환이 가속화되면서 학교 교육에서 데이터는 문제를 발견하고 설명하는 근거로 활용되고 있다. 이에 따라 학습자는 자료를 수집하고 정리하는 기능뿐 아니라, 자료의 의미를 해석하고 분석 결과를 근거로 자신의 주장을 설명할 수 있어야 한다. 중·고등학생의 디지털 미디어 리터러시 인식 연구는 2022 개정 교육과정이 정보의 수용과 생산, 사회적 문제 해결을 강조하는 방향으로 전개되고 있음을 보여주었다[1]. 또한 데이터 기반 과학 탐구 보고서 분석 연구는 학생들이 자료수집과 시각화에 비해 질문 생성, 데이터 추출 및 전처리, 데이터 평가 과정에서 어려움을 겪을 수 있음을 보여주었고[2], 데이터 기반 과학 탐구 사례 연구는 실제 자료를 활용한 탐구의 가능성을 제시하였다[3].
데이터 리터러시는 자료를 수집하고 이해하며, 분석하고 평가하고, 이를 적절한 방식으로 표현하고 소통하는 역량으로 설명된다[4]. 데이터 리터러시 교육 연구는 문제중심학습(PBL), 노벨 엔지니어링, 인공지능 융합 프로젝트와 같은 통합적 수업 설계 모델을 중심으로 전개되어 왔으며, 데이터 시각화와 이를 활용한 토론과 같은 구체적인 인지적‧사회적 학습 활동을 다루어 왔다[5]-[9]. 이러한 연구들은 데이터 리터러시 교육의 필요성과 다양한 수업 적용 가능성을 보여주었으나, 주로 프로그램 개발이나 수업 전후 변화 확인에 초점을 두었다. 따라서 실제 수업 맥락에서 학생들이 탐구문제를 설정하고, 자료를 선택하며, 분석 결과를 산출물로 구조화하는 과정을 구체적으로 확인할 필요가 있다.
학생 산출물은 데이터 탐구 수업에서 나타난 수행 특징을 확인할 수 있는 자료이다. 특히 통계포스터형 산출물은 탐구문제, 자료수집, 분석 결과, 그래프, 해석, 결론을 한 장의 시각 자료 안에 구조화한다는 점에서 학생의 데이터 탐구 수행을 살펴보기에 적절하다. 통계포스터 관련 연구는 통계포스터가 탐구 질문, 자료수집, 분석, 결론에 이르는 탐구과정 전반을 담고 있음을 보여주었으며[10],[11], 전국학생통계활용대회 개최 요강 역시 주제 접근의 타당성, 문제 해결의 합리성, 통계분석의 이해도, 표현과 전달 태도를 평가 기준으로 제시하고 있다[12]. 다만 통계포스터형 산출물이 시각적으로 정리되어 있다는 사실만으로 탐구가 적절하게 이루어졌다고 판단하기는 어렵다. 산출물 분석에서는 탐구문제와 자료의 연결성, 그래프 선택의 적절성, 해석과 결론의 타당성, 자료 출처 제시를 함께 검토해야 한다[13].
이에 본 연구는 중·고등학생을 대상으로 데이터 탐구 프로젝트 수업을 적용하고, 수업 전후의 데이터 리터러시 자기평가와 최종 통계포스터형 산출물을 함께 분석하고자 한다. 본 연구의 수업은 공공데이터 탐색, 자가수집 자료 확보, Python 기반 분석 및 시각화, 통계포스터형 산출물 제작의 흐름으로 구성되었다. 이때 통계포스터형 산출물은 전국학생통계활용대회의 공식 제출 형식과 동일한 결과물이 아니라, 탐구문제, 자료수집, 분석, 시각화, 해석, 결론을 한 장의 시각 자료에 구조화하여 제시한 수업 산출물을 의미한다.
본 연구는 자기평가 결과와 산출물 분석 결과를 동일한 능력의 반복 측정값으로 보지 않고, 데이터 탐구 프로젝트 수업의 결과를 서로 다른 측면에서 보여주는 자료로 해석하고자 한다. 구체적인 연구 질문은 다음과 같다.
첫째, 데이터 탐구 프로젝트 수업 적용 전후에 학습자의 데이터 리터러시 자기평가에는 어떠한 변화가 나타나는가?
둘째, 데이터 탐구 프로젝트 수업을 통해 제작된 통계포스터형 산출물은 자료수집, 분석, 시각화, 해석, 표현의 측면에서 어떠한 특징을 보이는가?
셋째, 수업 종료 시점의 데이터 리터러시 자기평가와 통계포스터형 산출물 평가 결과 간에는 어떠한 관련성이 나타나는가?
Ⅱ. 관련 연구
2-1 데이터 리터러시와 데이터 탐구 수업
데이터 리터러시는 데이터를 읽고 해석하는 능력에만 한정되지 않는다. 교육 맥락에서 데이터 리터러시는 필요한 데이터를 수집하고, 이를 분석·평가하며, 분석 결과를 적절한 방식으로 표현하고 소통하는 역량으로 이해된다. 데이터 리터러시 측정 도구 연구에서는 데이터 이해 및 수집, 데이터 분석, 데이터 평가, 데이터 도구 활용, 데이터 표현, 데이터 기반 의사소통을 주요 하위 영역으로 제시하였다[4]. 본 연구도 이 구분을 바탕으로 데이터 탐구과정에서 요구되는 데이터 리터러시 자기평가 변화를 분석하였다.
데이터 탐구 수업은 학습자가 스스로 탐구문제를 설정하고, 자료를 탐색·수집하며, 이를 분석하고 해석한 뒤 결과를 표현하는 활동으로 구성된다. 선행연구에서도 데이터 탐구 활동은 문제 설정, 자료 탐색, 데이터 분석, 결과 해석, 산출물 제작과 공유의 흐름으로 제시되어 왔다[6],[14]-[16]. 이는 데이터 탐구 수업이 단순한 도구 사용 수업이 아니라, 데이터에 기반하여 문제를 해석하고 그 결과를 표현하는 과정으로 설계되어야 함을 보여준다.
본 연구는 이러한 논의를 바탕으로 공공데이터 탐색, 자가수집 자료 확보, Python 기반 분석 및 시각화, 통계포스터형 산출물 제작을 하나의 데이터 탐구 수업 흐름으로 구성하였다. 여기서 Python은 프로그래밍 기능 자체를 평가하기 위한 대상이 아니라, 자료 정리와 분석, 시각화를 지원하는 도구로 사용하였다. 특히 공공데이터와 자가수집 자료를 동일한 절차로 정리하고, 분석 결과를 표와 그래프로 반복적으로 수정·확인할 수 있다는 점에서 본 수업의 분석 도구로 활용하였다. 따라서 본 연구의 초점은 Python 문법 습득 여부가 아니라, 학생들이 데이터를 바탕으로 탐구문제를 구체화하고 분석 결과를 해석하여 산출물로 구조화하는 데이터 리터러시 역량에 있다.
2-2 통계포스터형 산출물의 분석 관점
통계포스터형 산출물은 데이터 탐구 프로젝트 수업의 최종 결과물이자, 학생의 수행 특징을 드러내는 분석 자료가 된다. 통계포스터 관련 연구에서는 통계포스터가 탐구 질문, 자료수집, 분석 결과, 결론에 이르는 탐구과정 전반을 포함하고 있어 학생의 통계적 탐구를 분석할 수 있는 자료이다[10],[11]. 또한 전국학생통계활용대회 개최 요강에서도 통계포스터 평가 시 주제 접근의 타당성, 문제 해결의 합리성, 통계분석의 이해도, 표현과 전달 태도를 함께 고려하고 있다[12]. 따라서 통계포스터형 산출물은 단순히 시각적으로 정리된 결과물이 아니라, 탐구문제 설정, 자료 선택, 분석 방법, 그래프 구성, 해석과 결론 제시 방식이 함께 드러나는 수행 자료로 볼 수 있다.
본 연구에서 사용하는 통계포스터형 산출물은 전국학생통계활용대회의 공식 제출 형식과 동일한 결과물을 의미하지 않는다. 본 연구에서는 탐구문제, 자료수집, 분석, 시각화, 해석, 결론을 한 장의 시각 자료에 구조화하여 제시한 수업 결과물을 통계포스터형 산출물로 명명하였다. 따라서 산출물 분석에서는 그래프의 유무나 외형적 완성도만이 아니라, 탐구문제와 자료의 연결성, 그래프 선택의 적절성, 분석 결과에 근거한 해석과 결론 제시, 자료 출처의 충실성을 함께 검토할 필요가 있다[2],[12],[13].
기존 연구는 데이터 리터러시 교육의 필요성과 수업 적용 가능성을 보여주었고, 데이터 기반 탐구 보고서와 통계포스터 관련 연구는 학생 산출물을 통해 질문 생성, 자료수집, 분석, 시각화, 해석의 특징을 살펴볼 수 있음을 보여주었다[2],[10],[11],[13]. 그러나 기존 연구는 주로 교육 프로그램 개발, 수업 적용 효과, 산출물의 특정 요소 분석에 초점을 두었다. 이에 비해 본 연구는 중·고등학생의 실제 수업 맥락에서 공공데이터 탐색, 자가수집 자료 확보, Python 기반 분석 및 시각화, 통계포스터형 산출물 제작을 하나의 수업 흐름으로 구성하고, 수업 전후 자기평가 변화와 최종 산출물의 수행 특징을 함께 분석한다는 점에서 차이가 있다. 이에 본 연구는 데이터 리터러시 자기평가 분석과 통계포스터형 산출물 분석을 병행하여, 학습자의 인식 변화와 산출물에 나타난 수행 특징을 함께 분석하고자 한다.
Ⅲ. 연구 방법
3-1 연구 설계와 연구 대상
본 연구는 데이터 탐구 프로젝트 수업을 적용한 뒤, 학습자의 데이터 리터러시 자기평가 변화와 최종 통계포스터형 산출물의 특징을 함께 분석한 연구이다. 연구 설계는 단일집단 사전·사후 설계로 하였다. 수업 시작 전에는 데이터 리터러시 자기평가 사전 설문을 실시하였고, 총 12회기 수업이 종료된 뒤 동일한 문항으로 사후 설문을 실시하였다. 또한 수업 과정에서 제작된 최종 통계포스터형 산출물을 수집하여 별도의 평가 기준에 따라 분석하였다. 연구 설계의 개요는 표 1과 같다.

Research design overview
연구 대상은 Python 기초 학습 경험이 있는 중·고등학생 30명이다. 참여자는 중학생 8명과 고등학생 22명으로 구성되었다. 중학생은 2학년 2명, 3학년 6명이었으며, 고등학생은 1학년 12명, 2학년 10명이었다. 성별은 남학생 22명, 여학생 8명이었고, 중학생 8명은 모두 남학생이었다. 본 수업은 정규 교과수업이 아니라 지역 교육기관에서 운영한 비교과 프로젝트형 프로그램으로 진행되었으며, 참여자는 해당 프로그램에 신청한 학생들로 구성되었다. 다만 학년과 성별은 연구 결과를 분석하기 위한 변인으로 사용하지 않았고, 연구대상 특성을 설명하기 위한 배경 정보로만 제시하였다.
연구 참여자는 디지털 도구를 활용해 자료를 정리하고 간단한 시각화 활동에 참여할 수 있는 수준의 Python 경험을 가지고 있었다. 본 연구에서 Python 기초 경험은 고급 프로그래밍 능력이나 Python 자체의 학습 효과를 의미하지 않으며, 수업에서 제공된 예제와 안내를 바탕으로 자료 정리, 기본 분석, 표와 그래프 생성 활동에 참여할 수 있는 정도를 의미한다. 파일 불러오기와 라이브러리 활용도 독립적으로 코드를 설계하는 수준이 아니라, 제공된 코드와 교사의 안내를 바탕으로 자료 분석과 시각화에 활용하는 수준으로 다루었다. 따라서 연구 대상은 데이터 탐구 과정에서 Python을 기초적인 분석 도구로 활용할 수 있는 학습자로 설정하였다.
연구 참여자와 보호자에게 연구 목적과 자료 활용 범위를 안내하고 동의를 확인하였다. 수집된 자료는 개인 식별 정보가 드러나지 않도록 코드화하였으며, 분석 과정에서는 참여자 이름, 학교명 등 식별 가능한 정보를 제외하였다. 사전 설문, 사후 설문, 최종 통계포스터형 산출물은 동일한 참여자 코드로 대응시켜 관리하였다.
3-2 수업 운영 절차 및 내용
데이터 탐구 프로젝트 수업은 총 12회기, 회기당 100분으로 운영하였다. 전체 수업은 표 2와 같이 주제 탐색, 탐구문제 구체화, 자료 수집, Python 기반 분석·시각화, 통계포스터형 산출물 제작, 최종 제출 및 사후 설문의 흐름으로 구성하였다.
Procedure of data inquiry project class
수업의 핵심은 Python 코드 작성 자체가 아니라, 학생들이 자신의 탐구문제를 자료로 확인하고 분석 결과를 해석하여 한 장의 통계포스터형 산출물로 구조화하는 데 있다.
도입 및 탐색 단계(1~6회기)에서는 학생들이 관심 주제를 탐색하고, 이를 자료로 확인 가능한 탐구문제로 좁히는 활동을 진행한다. 이후 학생들은 탐구문제와 관련된 공공데이터를 탐색하고, 필요한 경우 설문이나 간단한 조사와 같은 자가수집 자료를 확보한다. 이 과정에서 자료의 출처, 수집 방법, 자료의 한계도 함께 검토하도록 하였다.
분석 단계(7~8회기)에서는 수집한 자료를 정리하고 Python을 활용하여 자료 분석과 시각화를 수행하였다. 학생들은 기본 통계량 확인, 표와 그래프 생성 과정을 통해 탐구문제와 자료의 연결성을 점검하였다. 이때 그래프는 산출물에 삽입하기 위한 요소가 아니라, 탐구문제에 대한 근거 자료로 활용되도록 하였으며, 자료의 특성, 결론과의 연결성, 해석의 과도한 일반화 여부를 확인하고 수정하도록 하였다.
해석 및 정리 단계(9~12회기)에서는 분석 결과를 바탕으로 통계포스터형 산출물을 제작하였다. 학생들은 탐구동기, 탐구문제, 자료수집 방법, 분석 결과, 그래프, 해석, 결론이 한 장의 시각 자료 안에서 논리적으로 연결되도록 구성하였다. 이 단계에서는 포스터의 미적 완성도보다 탐구문제와 자료, 그래프와 해석, 결론 사이의 연결성을 우선적으로 점검하였다. 특히 공공데이터와 자가수집 자료를 함께 사용한 경우에는 두 자료의 성격과 한계를 구분하고, 각 자료가 탐구문제에 제공하는 근거를 설명하도록 지도하였다.
수업 과정에서 생성형 AI 도구는 탐구문제 표현 점검과 해석 오류 확인을 위한 보조 도구로만 활용하였다. 자료 선택, 분석 결과 해석, 최종 결론 구성은 학생의 탐구 활동과 교사의 피드백을 중심으로 이루어졌으며, 생성형 AI가 산출물의 주된 생성 도구로 사용되지 않도록 하였다.
3-3 연구 도구와 자료 분석 기준
본 연구에서 활용한 연구 도구는 데이터 리터러시 자기평가 설문지와 통계포스터형 산출물 평가 루브릭이다. 데이터 리터러시 자기평가 설문지는 수업 전후 학습자의 자료 활용 역량에 대한 인식 변화를 확인하기 위해 사용하였다. 본 연구의 자기평가 설문지는 탐색적 요인분석과 확인적 요인분석을 통해 타당도를 확보한 정윤숙과 유지원[4]의 데이터 리터러시 측정 도구를 참고하여 구성하였다.
데이터 이해 및 수집, 데이터 분석, 데이터 평가, 데이터 도구 활용, 데이터 표현, 데이터 기반 의사소통의 6개 하위요인과 19개 문항을 유지하되, 중·고등학생을 대상으로 한 데이터 탐구 프로젝트 수업 맥락에 맞게 일부 문항 표현을 수정하였다. 그리고 컴퓨터교육 전공 교수 1인의 검토를 거쳐 문항 표현과 연구 맥락의 적합성을 확인하였다. 최종 설문은 총 19문항으로 구성하였고, 각 문항은 1점 ‘전혀 그렇지 않다’에서 4점 ‘매우 그렇다’까지의 4점 리커트 척도로 응답하도록 하였다.
각 하위요인은 데이터 탐구 과정에서 요구되는 주요 역량을 반영하도록 구성하였다. 자료의 이해 및 수집, 분석, 평가 영역은 자료를 파악하고 분석하며 출처와 해석의 타당성을 점검하는 능력과 관련되고, 도구 활용, 표현, 자료 기반 의사소통 영역은 디지털 도구를 활용하여 자료를 정리·시각화하고 결과를 설명하는 능력과 관련된다. 표 3은 데이터 리터러시 자기평가 설문지의 하위요인과 문항 구성을 개략적으로 제시한 것이다.
Composition of data literacy self-assessment questionnaire
통계포스터형 산출물에 대한 평가는 통계청 주관 전국학생통계활용대회의 포스터 심사기준[12]을 참고하되, 본 연구의 수업 산출물 맥락에 맞게 창의성·탐구성, 논리 타당성, 통계·자료 분석의 타당성, 표현성의 네 영역으로 구성하였다. 각 영역은 4수준으로 평정한 뒤 영역별 배점에 따라 환산하였으며, 최종 총점은 네 영역의 환산 점수를 합산하여 산출하였다. 산출물 평가는 연구자 1인과 동료 교사 1인이 표 4에 제시된 루브릭에 근거하여 독립적으로 수행하였으며, 평가자 간 일치도를 확인한 뒤 최종 분석에는 두 평가자의 평정 값 평균을 사용하였다.
Rubric for statistical poster-type output evaluation
구체적으로 평가는 탐구문제의 구체성, 자료와 분석 결과의 연결성, 통계·자료 분석의 타당성, 시각적 구성과 전달 효과를 중심으로 이루어졌다. 본 연구에서 산출물 평가는 학생의 데이터 리터러시 전체 수준을 직접 측정하기 위한 도구라기보다, 수업 과정에서 제작된 통계포스터형 산출물에 나타난 수행 특징을 분석하기 위한 기준으로 활용하였다.
자료 분석은 다음과 같이 이루어졌다. 먼저 데이터 리터러시 자기평가 설문지의 내적 일관성을 확인하기 위해 Cronbach’s α를 산출하였다. 본 연구는 데이터 리터러시 측정도구 자체를 새롭게 개발하거나 타당화하는 연구가 아니므로, Cronbach’s α는 본 연구 자료에서 문항 응답의 내적 일관성을 확인하는 수준으로 해석하였다. 이후 수업 전후 자기평가 변화는 동일 학생의 사전·사후 응답을 비교하는 자료이므로 대응표본 t검정을 실시하였다. 또한 수업 종료 시점의 데이터 리터러시 자기평가와 통계포스터형 산출물 평가 결과 간의 관련성을 확인하기 위해 Spearman의 순위상관분석을 실시하였다. 통계적 유의수준은 α=.05로 설정하였다.
본 연구에서 데이터 리터러시 자기평가 결과는 실제 수행 능력의 직접 측정값으로 해석하지 않았다. 자기평가 설문은 학습자가 자신의 자료 활용 가능성과 수행 자신감을 어떻게 인식하는지를 확인하기 위한 자료이고, 통계포스터형 산출물 평가는 수업 과정에서 나타난 수행 특징을 살펴보기 위한 자료이다. 따라서 본 연구에서는 자기평가 변화와 산출물 평가 결과를 데이터 탐구 프로젝트 수업의 결과를 서로 다른 측면에서 보여주는 자료로 해석하였다.
Ⅳ. 연구 결과
4-1 데이터 리터러시 사전·사후 설문 분석
본 연구에서는 데이터 리터러시 자기평가 설문지의 내적 일관성을 확인하기 위해 Cronbach’s α를 산출하였다. 분석 결과, 전체 19개 문항의 Cronbach’s α는 .89로 나타났다. 하위요인별로는 자료 이해 및 수집 .84, 자료 분석 .82, 자료 평가 .74, 도구활용 .90, 자료 표현 .86, 자료 기반 의사소통 .89로 나타나, 본 연구에서 사용한 자기평가 설문지가 전체적으로 수용 가능한 수준의 내적 일관성을 보였음을 확인하였다.
수업 전후 데이터 리터러시 자기평가 변화를 확인하기 위해 동일 학생의 사전·사후 응답을 대응표본 t검정으로 비교하였다. 표 5는 전체 및 하위요인별 사전·사후 평균, 표준편차, 대응표본 t검정 결과와 효과크기(Cohen’s dz)를 요약한 것이다.
Pre- and post-test results of data literacy self-assessment
표 5에 제시한 바와 같이, 전체 데이터 리터러시 자기평가 평균은 사전 2.77에서 사후 3.19로 높아졌으며, 이 차이는 통계적으로 유의하였다(t=12.08, p<.001). 모든 하위요인에서도 사후 평균이 사전 평균보다 높게 나타났고, 대응표본 t검정 결과 모두 유의수준 .05 기준에서 통계적으로 유의하였다. 이는 수업 이후 학생들이 자료 수집, 정리, 분석 및 해석에 이르는 데이터 리터러시 수행 과정 전반에 대해 긍정적으로 인식하게 되었음을 보여준다. 효과크기(Cohen’s dz)는 전체 2.206, 하위요인별 .798~1.523으로 나타나, 교육적 효과가 큰 것으로 나타났다.
다만 이 결과는 실제 데이터 리터러시 수행 능력이 직접적으로 향상되었음을 입증하는 자료로 해석하기 어렵다. 본 연구의 설문은 자기평가형 문항으로 구성되어 있으므로, 표 5의 결과는 수업 이후 학습자가 자신의 데이터 활용 가능성과 수행 자신감을 더 높게 인식하게 되었음을 보여주는 자료로 해석하는 것이 적절하다.
4-2 통계포스터형 산출물 분석
수업을 통해 제작된 통계포스터형 산출물 30편을 대상으로 창의성·탐구성, 논리 타당성, 통계·자료 분석 타당성, 표현성의 네 영역에서 나누어 연구자와 동료 교사가 루브릭에 따라 독립적으로 평정하였다. 평가자 간 일치도를 확인하기 위하여 영역별 평정에서는 가중 카파 계수(κw), 총점에 대해서는 급내상관계수(ICC, Intraclass Correlation Coefficient)를 산출하였다. 각 평가 영역의 값은 4수준 평정값의 평균을 기준으로 제시하였으며, 총점은 영역별 배점을 반영하여 100점 만점으로 환산하였다. 평가자 간 일치도는 영역별로 κw=.40~.84로 나타났고, 총점의 ICC(2,1)=.63으로 확인되었다. 표 6은 평가자별 평균 평정 결과를 요약한 것이다.
Average rating results of statistical poster-type outputs by evaluator
표 6에 제시한 바와 같이, 두 평가자 모두 네 평가 영역에서 평균 3점대의 평정 값을 부여하였다. 특히 통계·자료 분석 타당성은 두 평가자 모두 3.47로 동일하게 나타났다. 반면 표현성에서는 동료 교사 3.50, 연구자 3.20으로 차이가 나타났다. 특히 표현성 영역의 평가자 간 일치도는 κw=.40으로 다른 영역보다 낮게 나타났다. 이는 시각적 구성, 가독성, 전달 효과와 같은 요소를 평가할 때 평가자 간 판단 차이가 상대적으로 크게 나타날 수 있음을 의미한다. 따라서 산출물 평가 결과는 개별 평가자의 점수나 절대적 점수로 해석하기보다, 본 연구의 루브릭에 근거하여 산출물에 나타난 수행 특징을 탐색적으로 파악한 결과로 해석할 필요가 있다. 이에 본 연구에서는 두 평가자의 평정값 평균을 최종 분석에 활용하였다.
최종 산출물 총점은 75점에서 100점 사이에 분포하였고, 전체 평균은 84.28점으로 나타났다. 점수만 보면 전반적으로 산출물이 완성도가 양호한 편으로 볼 수 있으나, 산출물의 질적 차이는 단순히 총점만으로 설명하기 어렵다. 실제 산출물에서는 탐구문제의 구체성, 자료수집 방식, 그래프 선택, 해석 범위, 결론의 근거 제시 방식에서 차이가 나타났다.
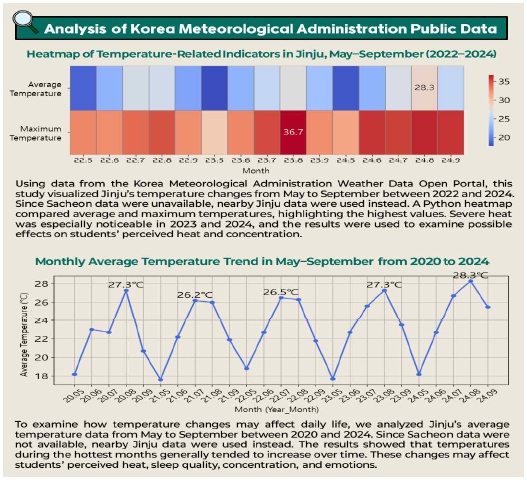
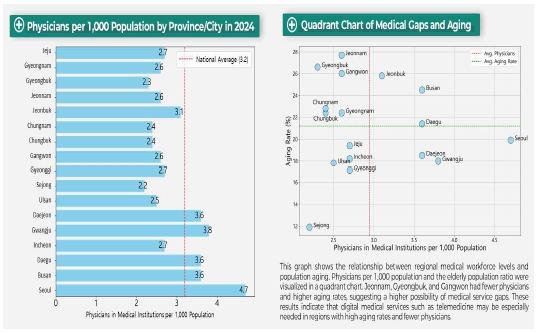
산출물은 탐구주제와 설명 방식의 성격에 따라 사회 구조형 20편, 생활 경험형 7편, 기술 인식형 3편으로 구분하여 살펴보았다. 각 유형의 설명 양상을 보여주기 위해 생활 경험형, 사회 구조형, 기술 인식형 사례를 각각 그림 1, 그림 2, 그림 3에 제시하였다. 다만 산출물 간 차이는 주제 유형 자체보다 탐구문제의 구체화, 자료 역할 구분, 그래프 선택 구조, 결론 점검 등 수업 단계별 수행의 충실도에서 더 뚜렷하게 나타났다.
그림 1에 제시된 생활 경험형 사례는 학생의 일상 경험에서 출발하여 공공데이터, 설문, 인터뷰 자료를 결합한 산출물이다. 이 유형은 학생의 관심과 탐구 동기가 분명하게 드러난다는 장점이 있었으나, 개인 경험과 자료 분석 결과를 연결하는 과정에서 해석이 넓어질 수 있다는 한계도 있었다. 특히 생활 경험형 산출물에서는 공공데이터 그래프가 제시되어 있더라도, 그 그래프가 학생의 설문이나 인터뷰 자료와 어떤 방식으로 연결되는지 충분한 설명이 필요하다.
Partial example of a life-experience-type output
그림 2에 제시된 사회 구조형 사례는 지역, 제도, 집단 간 차이와 관련된 공공데이터를 활용한 산출물이다. 이 유형에서는 자료의 비교 기준이 명확한지, 지역 범위와 단위가 일관되는지가 중요하다. 예를 들어 지역별 수치나 분포를 비교하는 산출물은 구조적 차이를 보여주는 데에는 적절했지만, 이를 곧바로 원인 설명으로 확장할 경우 해석의 범위가 넓어지는 문제가 나타날 수 있다. 따라서 사회 구조형 산출물에서는 ‘원인’을 단정하기보다 차이, 분포, 경향, 관련성 수준에서 결론을 제시하는 것이 바람직하다.
Partial example of a social-structure-type output
그림 3에 제시된 기술 인식형 사례는 새로운 기술에 대한 학생의 인식, 태도, 행동 변화를 다룬 산출물이다. 이 유형은 주제의 시의성과 학생 관련성이 높다는 장점이 있으나, 자료가 보여주는 수준이 인식 비교인지, 실제 영향 관계인지 구분하는 것이 중요하다. 예를 들어 설문 결과나 인식 비교 그래프를 바탕으로 기술이 학생의 행동에 ‘영향을 미쳤다’고 표현하면 인과관계를 암시할 수 있다. 따라서 기술 인식형 산출물에서는 자료가 보여주는 범위를 ‘인식 차이’, ‘응답 경향’, ‘관련성’ 수준으로 제한하여 해석할 필요가 있다.
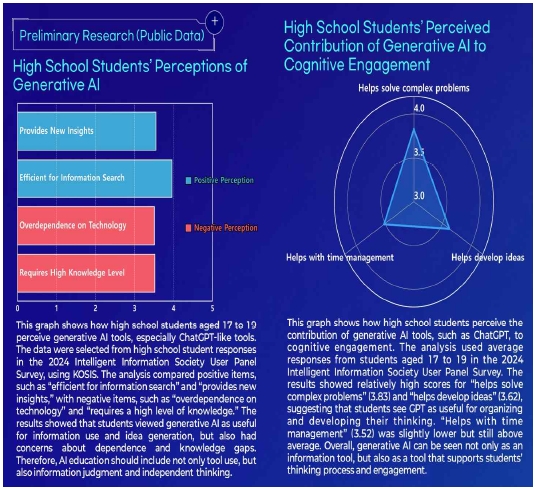
Partial example of a technology-perception-type output
통계포스터형 산출물은 대체로 탐구문제, 자료수집 방법, 분석 결과, 그래프, 해석, 결론의 기본 구조를 갖추고 있었다. 그러나 산출물별 차이는 외형적 완성도나 그래프의 유무보다 탐구문제와 자료의 연결성, 그래프 선택과 해석의 적절성, 자료에 근거한 결론 제시 여부에서 더 뚜렷하게 나타났다. 특히 공공데이터와 자가수집 자료를 함께 활용한 산출물에서는 두 자료의 성격이 다르다는 점을 명시하고, 각각의 자료가 탐구문제에 어떤 근거를 제공하는지 설명하는 과정이 중요하다. 이러한 점에서 통계포스터형 산출물은 단순한 결과 정리물이 아니라, 학생이 데이터 탐구과정을 어떻게 구조화하고 해석했는지를 보여주는 수행 자료로 볼 수 있다.
4-3 사후 데이터 리터러시 자기평가와 통계포스터형 산출물의 상관관계 분석
수업 종료 시점의 데이터 리터러시 자기평가와 통계포스터형 산출물 평가 결과 사이의 관련성을 확인하기 위해 Spearman의 순위상관분석을 실시하였다. 상관분석에는 사후 데이터 리터러시 자기평가 점수와 통계포스터형 산출물 총점을 사용하였다. 이는 최종 산출물이 수업 종료 시점의 수행 결과이므로, 산출물 평가 점수와 같은 시점의 자기평가 인식을 대응하여 분석하는 것이 본 연구 목적에 적절하다고 판단했기 때문이다. 또한 연구 대상이 30명으로 제한되어 있고, 산출물 평가 점수가 루브릭 평정 결과를 배점에 따라 환산한 점수라는 점을 고려하여, 두 변인의 순위적 관련성을 확인할 수 있는 Spearman의 순위상관분석을 사용하였다.
분석 결과, 사후 데이터 리터러시 자기평가 총점과 통계포스터형 산출물 총점 간에는 유의한 정적 상관이 나타났다(ρ=.667, p<.001). 이는 수업 종료 시점에 자신의 자료 활용 역량을 높게 인식한 학생일수록 통계포스터형 산출물에서도 높은 점수를 받는 경향이 있었음을 의미한다. 그러나 이 결과는 두 변인이 전체 수준에서 함께 움직인 경향을 보여주는 것이며, 자기평가 점수가 산출물 점수를 직접적으로 설명하거나 예측한다는 의미는 아니다. 표 7은 사후 데이터 리터러시 자기평가 하위요인과 통계포스터형 산출물 총점 간의 상관관계를 정리한 것이다.
Correlations between post-test self-assessment and output score
표 7에 제시된 바와 같이, 사후 데이터 리터러시 자기평가 하위요인 중 자료 이해 및 수집, 자료 분석, 자료 평가, 도구 활용은 통계포스터형 산출물 총점과 유의한 정적 상관을 보였다. 특히 도구 활용은 산출물 총점과 가장 높은 정적 상관을 보였다(ρ=.669, p<.001). 이는 자료를 이해·수집하고, 분석·평가하며, 도구를 활용하여 자료를 처리할 수 있다고 인식한 학생일수록 통계포스터형 산출물 총점도 높은 경향이 있었음을 보여준다.
반면 자료 표현과 자료 기반 의사소통은 통계포스터형 산출물 총점과 유의한 상관을 보이지 않았다. 이는 학생이 자신의 표현 능력이나 의사소통 능력을 높게 평가한다고 해서 곧바로 산출물 총점이 높게 나타나는 것은 아님을 보여준다. 통계포스터형 산출물 총점은 표현성뿐 아니라 탐구문제의 구체성, 자료수집의 적절성, 분석과 해석의 타당성, 결론의 논리성 등 여러 요소를 종합하여 산출되기 때문이다.
따라서 본 연구의 상관관계 분석 결과는 데이터 리터러시 자기평가와 통계포스터형 산출물 평가가 전체 수준에서 정적 관련성을 보이지만, 두 자료가 동일한 능력을 측정한 결과는 아니라는 점을 함께 보여준다. 자기평가 결과는 학습자가 자신의 자료 활용 능력과 수행 자신감을 어떻게 인식하는지를 보여주는 자료이고, 산출물 평가는 실제 수업 과정에서 제작된 결과물에 나타난 수행 특징을 보여주는 자료이다. 그러므로 데이터 탐구 프로젝트 수업의 결과를 해석할 때에는 자기평가 변화와 산출물 평가 결과를 함께 보되, 두 자료의 성격을 구분하여 해석할 필요가 있다.
Ⅴ. 결론 및 제언
본 연구는 데이터 탐구 프로젝트 수업 이후 나타난 학습자의 데이터 리터러시 자기평가 변화와 통계포스터형 산출물에 나타난 수행 특징을 분석하였다. 데이터 리터러시에 대한 학습자의 인식 변화를 확인하기 위하여 자기평가 설문지를 사용하였고, 수업 과정에서 나타난 학생들의 수행 특징을 확인하기 위하여 통계포스터형 산출물을 분석하였다. 연구 결과는 다음과 같다.
첫째, 데이터 리터러시 자기평가 전체 평균은 사전 2.77에서 사후 3.19로 높게 나타났으며, 대응표본 t검정 결과 이 차이는 통계적으로 유의하였다(t=12.081, p<.001). 하위요인별로도 모든 영역에서 사후 평균이 사전 평균보다 높게 나타났다. 다만 본 설문은 자기평가형 문항으로 구성되었으므로, 이 결과를 실제 데이터 리터러시 수행 능력의 직접적 향상으로 단정하기는 어렵다. 따라서 본 연구에서는 이를 실제 수행 능력의 직접적 향상이 아니라, 수업 이후 데이터 리터러시 자기평가가 긍정적으로 변화한 결과로 해석하였다.
둘째, 통계포스터형 산출물은 대체로 탐구문제, 자료수집 방법, 분석 결과, 그래프, 해석, 결론의 기본 구조를 갖추고 있었다. 그러나 산출물별로 탐구문제의 구체성, 자료와 탐구문제의 연결성, 그래프 선택과 해석의 적절성, 자료에 근거한 결론 제시 수준에서 차이가 나타났다. 이는 통계포스터형 산출물을 평가할 때 외형적 완성도나 그래프의 유무만을 볼 것이 아니라, 탐구문제, 자료, 분석, 해석, 결론 사이의 연결 구조를 함께 살펴볼 필요가 있음을 보여준다.
셋째, 사후 데이터 리터러시 자기평가 총점과 통계포스터형 산출물 총점 간에는 유의한 정적 상관이 나타났다(ρ=.667, p<.001). 하위요인 중 자료 이해 및 수집, 자료 분석, 자료 평가, 도구 활용은 유의한 상관을 보였으나, 자료 표현과 자료 기반 의사소통은 유의한 상관을 보이지 않았다. 이는 자기평가와 산출물 평가가 전체 수준에서는 정적 상관을 보이지만, 두 자료가 동일한 능력을 측정한 결과는 아니라는 점을 보여준다. 따라서 데이터 탐구 프로젝트 수업의 결과를 해석할 때에는 자기평가 변화와 산출물에 나타난 수행 특징을 함께 보되, 두 자료의 성격을 구분해야 한다.
수업 운영 측면에서는 다음과 같은 점을 고려할 수 있다.
첫째, 데이터 탐구 프로젝트 수업에서는 탐구문제를 구체화하는 단계를 강화해야 한다. 본 연구의 산출물 차이는 주로 탐구문제와 자료의 연결성, 분석 결과와 결론의 관계에서 나타났다. 따라서 수업 초반에는 학생의 관심 주제를 자료로 확인 가능한 질문으로 좁히고, 해당 질문에 적합한 자료가 무엇인지 검토하는 활동이 충분히 이루어져야 한다.
둘째, 공공데이터와 자가수집 자료를 함께 활용할 때에는 두 자료의 성격과 한계를 구분하여 지도해야 한다. 공공데이터는 공개된 자료로서 사회적 경향을 살펴보는 데 유용하지만, 학생 개인이나 특정 집단의 경험을 직접 설명하는 데에는 한계가 있을 수 있다. 반면 자가수집 자료는 탐구맥락과 밀접하게 연결될 수 있으나, 표본 수와 응답 편향의 영향을 받을 수 있다. 따라서 학생들이 각 자료가 탐구문제에 어떤 근거를 제공하는지 명확히 설명하도록 지도해야 한다.
셋째, 자료 분석과 시각화 활동에서는 그래프 생성 자체보다 그래프 선택과 해석의 타당성을 점검하는 과정이 중요하다. 산출물에 그래프가 포함되어 있더라도, 그래프가 탐구문제에 어떤 의미를 갖는지 충분히 설명되지 않거나 결론과 직접 연결되지 않는 경우가 있었다. 따라서 데이터 탐구 수업에서는 그래프를 만드는 활동과 함께, 그래프가 보여주는 경향, 해석 가능한 범위, 단정할 수 없는 내용을 함께 설명하도록 지도해야 한다.
다만 본 연구는 단일집단 사전·사후 설계로 이루어졌으며, 연구 대상도 Python 기초 학습 경험이 있는 중·고등학생 30명으로 제한되어 있다. 따라서 수업 이후 나타난 자기평가 변화나 산출물의 특징을 본 수업만의 효과로 단정하기에는 한계가 있으며, 연구 결과를 모든 중·고등학생에게 일반화하는 데에도 신중해야 한다. 또한 데이터 리터러시 사전·사후 설문은 자기평가형 문항으로 구성되어 있으므로, 설문 결과는 실제 데이터 분석 능력이나 비판적 평가 능력의 객관적 향상을 직접 입증하는 자료가 아니라 학습자가 자신의 데이터 활용 가능성을 어떻게 인식했는지를 보여주는 자료로 해석해야 한다. 마지막으로 통계포스터형 산출물 평가는 수업 맥락에서 제작된 결과물을 대상으로 하였으므로, 공식 대회 작품처럼 제작 조건이 엄격하게 통일된 자료로 보기는 어렵다. 특히 표현성 영역은 다른 영역에 비해 평가자 간 일치도가 상대적으로 낮게 나타났으므로, 후속 연구에서는 표현성 평가 기준을 더 세분화하고 평가자 간 해석 차이를 줄이기 위한 절차를 보완해야 한다.
References
-
J. Choi, “A Study on the Perception of Digital Media Literacy Among Middle and High School Students in Korea,” The Korean Journal of Literacy Research, Vol. 14, No. 2, pp. 241-276, April 2023.
[https://doi.org/10.37736/KJLR.2023.04.14.2.08]

-
J. W. Kim and Y. Ahn, “Analysis of Data Literacy Components in Data-Based Scientific Inquiry Reports,” School Science Journal, Vol. 18, No. 3, pp. 286-301, 2024.
[https://doi.org/10.15737/ssj.18.3.202408.286]
-
M. Y. Han, H. Kim, and D. H. Jeong, “A Case Study of the Data-Based Scientific Inquiry,” School Science Journal, Vol. 16, No. 2, pp. 165-178, 2022.
[https://doi.org/10.15737/ssj.16.2.202205.165]
-
Y. Chung and J. W. You, “Validation of a Data Literacy Measurement Tool for University Students and Diagnosis of Data Literacy among First-Year Students: Focusing on the Case of A University,” Korean Journal of General Education, Vol. 16, No. 5, pp. 245-260, October 2022.
[https://doi.org/10.46392/kjge.2022.16.5.245]
-
C.-I. Lim, J. Lee, Y. Song, W. Lee, H. Lee, and E. Lim, “A Study on the Development and Application of a Data Science Education Program for Elementary School Students,” Journal of Korean Association for Educational Information and Media, Vol. 28, No. 2, pp. 319-345, June 2022.
[https://doi.org/10.15833/KAFEIAM.28.2.319]
- J. Lee, S. Kim, and G. Kim, “Development of Education Program Based on Problem-Based Learning for the Enhancement of Data Literacy,” in Proceedings of the Korean Association of Computer Education Summer Conference, Vol. 25, No. 2(A), pp. 75-78, 2021.
-
H. J. Yoon, T. Kim, and K.-H. Kim, “Development and Application of a Novel Engineering-Based Data Literacy Education Program for Elementary Students,” The Journal of Learner-Centered Curriculum and Instruction, Vol. 23, No. 22, pp. 657-677, 2023.
[https://doi.org/10.22251/jlcci.2023.23.22.657]
-
Y. Cho and C. Kim, “The Effect of Artificial Intelligence Convergence Project Classes on Improving Data Literacy in Elementary Students,” Journal of The Korean Association of Information Education, Vol. 27, No. 3, pp. 375-383, June 2023.
[https://doi.org/10.14352/jkaie.2023.27.3.375]
-
A. Joo and M. R. Kim, “Effects of Discussion Classes Using Data Visualization Materials on Data Literacy of Elementary School Students,” The Journal of Korean Association of Computer Education, Vol. 27, No. 2, pp. 37-47, 2024.
[https://doi.org/10.32431/kace.2024.27.2.004]
-
J. M. Lee and Y. J. Yoo, “Analysis of Problem Statements in Poster Presentations of Statistical Investigation,” School Mathematics, Vol. 22, No. 4, pp. 967-993, December 2020.
[https://doi.org/10.29275/sm.2020.12.22.4.967]
-
S.-A. Choi and M. K. Kim, “A Study on Elementary School Students’ Statistical Literacy in a Statistics Poster Project Based on the Statistical Problem Solving Process,” Journal of the Korean School Mathematics Society, Vol. 28, No. 3, pp. 225-244, September 2025.
[https://doi.org/10.30807/ksms.2025.28.3.003]
- Statistics Korea, Guidelines for the 27th National Student Statistics Utilization Competition, Statistics Korea, Daejeon, April 2025.
-
M. Y. Baek and E. R. Hyun, “A Meta-Analysis of Represented Types of Data Visualization in Youth: Awards in the National Student Statistics Utility Competition from 2019 to 2021,” Archives of Design Research, Vol. 36, No. 2, pp. 285-301, May 2023.
[https://doi.org/10.15187/adr.2023.05.36.2.285]
-
Y. N. Seo, J. Noh, M. R. Park, and S. Jung, “A Developmental Study of an Instructional Model for Inquiry of Social Studies Based on Data-Driven Artificial Intelligence Convergence Education,” Journal of Learner-Centered Curriculum and Instruction, Vol. 23, No. 12, pp. 1-25, June 2023.
[https://doi.org/10.22251/jlcci.2023.23.12.1]
-
D. G. Noh, H. R. Oh, J. W. Yoon, and B. K. Jeon, “Development of Artificial Intelligence Convergence Problem-Solving Learning Instructional Model to Improve Data Literacy,” The Journal of Educational Development, Vol. 42, No. 3, pp. 739-769, February 2023.
[https://doi.org/10.34245/jed.42.3.739]
-
T. Y. Kim, S. Y. Moon, J. H. Baek, and S. J. Lee, “A Development of an Instructional Model for Data-Based Artificial Intelligence, Science, and Technology Convergence to Strengthen Digital Literacy,” Journal of Learner-Centered Curriculum and Instruction, Vol. 25, No. 4, pp. 987-1006, February 2025.
[https://doi.org/10.22251/jlcci.2025.25.4.987]
저자소개
2024년~현 재: 경상국립대학교 교육대학원 컴퓨터교육전공 석사과정
※관심분야:컴퓨터 교육, 데이터 탐구 프로젝트 교육, 코딩 등
1989년:중앙대학교(이학사)
1994년:중앙대학교(이학석사)
1998년:중앙대학교(컴퓨터공학 박사)
1998년~1999년: 첨단학술정보센터(KRIC) 선임연구원
1999년~2000년: 한국교육학술정보원(KERIS) 책임연구원
2013년~2014년: University of Notre Dame 방문학자
2024년~2025년: Nebraska State University(Omaha) 방문학자
2000년~현 재: 경상국립대학교 컴퓨터공학부 교수, 경상국립대학교 공학연구원(ERI) 자동화·컴퓨터연구센터 책임연구원
※관심분야:컴퓨터교육(Computer Education), 생체인식(Biometrics), 사람행동인식(HAR)