노인 체형 분류를 위한 신체 비율 지표의 통계적 특성과 원형 체형 도출
Copyright ⓒ 2026 The Digital Contents Society
This is an Open Access article distributed under the terms of the Creative Commons Attribution Non-CommercialLicense(http://creativecommons.org/licenses/by-nc/3.0/) which permits unrestricted non-commercial use, distribution, and reproduction in any medium, provided the original work is properly cited.
초록
본 연구는 한국 노인 특화 체형 분류 체계 도출을 위한 기초 연구로, 신체 비율 지표의 통계적 특성을 규명하고 원형 체형(Prototype Body Type) 군집을 탐색적으로 식별하며, 체형 분류에 유효한 핵심 변수를 통계적으로 검증하는 것을 목적으로 한다. 한국 노인 1,381명(남성 657명, 여성 724명, 65~96세)의 10개 신체 비율 지표를 분석하였다. K-means, Gaussian Mixture Model, Agglomerative Clustering, DBSCAN, Autoencoder+K-means 등 5가지 군집 방법의 성능을 실루엣 계수 및 Davies-Bouldin 지수로 비교해 모델을 평가했다. 본 연구는 한국 노인 신체 비율 지표의 통계적 기초값을 제시하고, DBSCAN 기반 두 개의 원형 체형을 탐색적으로 식별하며, 넙다리둘레/샅높이와 장딴지/넙다리(Calf/Thigh) 비율을 체형 분류 핵심 변수로 검증하고, WHtR은 보조 변수임을 확인하였다.
Abstract
This study aimed to establish foundational data for a body-type classification system specific to elderly Koreans by identifying the statistical characteristics of body-ratio indices, identifying prototype body types through exploratory clustering, and statistically validating key classification variables. Ten body-ratio indices of 1,381 elderly Koreans (657 men, 724 women, aged 65–96) were analyzed. The models were evaluated by comparing the performance of five clustering methods, including K-means, Gaussian mixture model, agglomerative clustering, Density-based Spatial Clustering of Applications with Noise (DBSCAN), and Autoencoder+K-means, using the silhouette coefficient and the Davies–Bouldin index. The results established baseline statistical values of Korean elderly body ratio indices, exploratorily identified two DBSCAN-based prototype body types, and validated the thigh/crotch-height and calf/thigh ratios as the key classification variables, with Waist-to-Height Ratio (WHtR) as an auxiliary indicator.
Keywords:
Older-Adult Body-Type Derivation, Prototype Body Type, Autoencoder, Body Ratio Index, Statistical Validity키워드:
노인 체형 도출, 원형 체형, 오토인코더, 신체 비율 지표, 통계적 타당성Ⅰ. 서 론
1-1 연구 배경 및 필요성
한국의 65세 이상 고령 인구는 2024년 전체 인구의 20%를 초과하여 공식적인 초고령사회로 진입하였다[1]. 이에 따라 노인 친화적 의류, 복지 기기, 생활 환경 설계에 대한 수요가 급증하고 있으나, 현행 설계 기준의 핵심 자료인 인체 치수 표준은 주로 20~69세 경제활동 인구를 대상으로 수집된 사이즈코리아(Size Korea) 데이터에 의존하고 있다[2]. 실제 성인의 체형은 일반적으로 신체 유형 분류 체계인 소마토타입(Somatotype)으로 정의되며, 외형의 시각적 패턴만으로도 어느 정도 판단이 가능하다. 그러나 소마토타입은 전 세계 공통 기준이어서 한국인의 체형 특성을 충분히 반영하지 못하며, 특히 65세 이상 노인에서는 그 한계가 더욱 두드러진다. 노인은 근감소증(Sarcopenia), 체지방 재분포, 신장 감소 등 신체 조성의 복합적 변화를 겪지만 이러한 변화가 외형적 패턴이나 현행 인체 치수 기준에 충분히 반영되지 않아, 시각적 판단만으로는 체형을 정확히 규정하기 어렵다[3]-[5].
특히 노화 과정에서 나타나는 신체 변화는 단일 부위에 국한되지 않고 전신에 걸쳐 비대칭적으로 진행된다. 사지의 골격근량은 감소하는 반면 체지방은 복부를 중심으로 재분포되며, 척추의 압박과 추간판 퇴행으로 신장이 줄어들어 동일한 둘레 계측치라도 신장 대비 상대적 비율은 크게 달라진다. 이러한 변화는 체중이나 체질량지수(BMI)와 같은 단일 절대 지표만으로는 포착되지 않으며, 겉으로 드러나는 외형과 실제 신체 조성 사이의 괴리를 키운다. 결과적으로 동일한 키와 몸무게를 가진 두 노인이라도 근육과 지방의 분포, 사지와 몸통의 비율은 상당히 다를 수 있어, 절대 계측치 중심의 기존 분류 체계로는 이들을 충분히 구분하기 어렵다.
이러한 배경에서 노인의 체형을 객관적으로 유형화하려는 시도는 의류 산업의 치수 표준화뿐 아니라, 노쇠(Frailty)와 대사 위험의 조기 선별이라는 보건학적 목표와도 맞닿아 있다. 체형은 신체 조성의 외적 결과물이므로, 적절히 정의된 체형 지표는 정밀한 임상 검사를 대체하지는 못하더라도 위험군을 일차적으로 선별하는 비침습적 보조 수단이 될 수 있다.
체형 분류(Body Type Classification) 연구는 다양한 신체 계측치 패턴을 몇 가지 대표적 유형으로 단순화하여 설계·생산에 활용 가능한 치수 기준을 도출하는 작업이다. 그러나 기존의 한국 노인 신체 계측 연구는 대부분 소규모 표본에 기반하거나, 절대 계측치 위주로 분석되었으며, 신체 비율 지표의 통계적 유의성 검증과 군집 방법의 체계적 비교가 부재한 실정이다[6],[7].
신체 비율 지표(Body Ratio Index)는 신장의 영향을 통제하여 개인 간 체형을 직접 비교할 수 있게 해 주므로, 절대 계측치가 가지는 한계를 보완하는 대안으로 주목받아 왔다. 그러나 어떤 비율 지표가 한국 노인의 체형 차이를 통계적으로 유의하게 설명하는지, 그리고 그러한 지표가 서로 다른 군집 방법에서 안정적으로 재현되는지에 대한 체계적 검증은 충분히 이루어지지 않았다. 또한 체형 군집을 도출하는 데에는 K-means, Gaussian Mixture Model, 밀도 기반 군집화, 딥러닝 기반 임베딩 등 다양한 방법이 활용될 수 있으나, 이들 방법이 동일한 자료에서 어떤 결과 차이를 보이는지를 정량적으로 비교한 연구는 드물다. 방법 선택에 따라 군집의 수와 경계가 달라질 수 있다는 점을 고려하면, 단일 방법에만 의존한 분류 결과는 재현성과 일반화 측면에서 한계를 지닐 수밖에 없다.
이러한 한계 때문에 신체 계측 자료를 활용한 체형 유형화 연구가 의류 산업과 보건 분야에서 폭넓게 수행되어 왔으며, 다변량 군집 분석을 통해 표준 치수 체계를 구축하는 접근이 정착되어 있다. 그러나 이러한 연구들은 대체로 특정 인종·연령 집단을 전제로 도출된 것이어서, 신체 비례와 노화 양상이 상이한 한국 노인 집단에 그대로 적용하기에는 한계가 있다. 더욱이 노인 인구는 동일 연령대 내에서도 건강 상태와 신체 조성의 개인차가 크기 때문에, 소수의 고정된 유형으로 환원하기보다 자료에 내재한 군집 구조를 자료 주도적으로(Data-Driven) 탐색하는 접근이 요구된다.
1-2 연구 목적
일반 성인의 체형은 과체중·비만 여부 등 주요 신체적 특성이 외형적으로 어느 정도 드러나기 때문에 시각적 판단이 비교적 용이하다. 그러나 노인 체형은 이와 다른 양상을 보인다. 노화에 따른 근감소증(Sarcopenia), 체지방의 복부 집중, 척추 후만증 등 신체 조성의 복합적 변화로 인해 겉으로는 표준 체형처럼 보이더라도 실제로는 대사적 위험이 높은 상태일 수 있다. 즉, 노인 체형은 외형만으로 건강 위험성을 정확히 파악하기 어렵다는 본질적인 한계를 지닌다.
이러한 외형과 건강 위험의 불일치는 노인 집단에서 특히 임상적 함의가 크다. 근육량 감소와 복부 지방 축적이 동시에 진행되는 근감소성 비만(Sarcopenic Obesity)의 경우, 표준 체중 범위에 속하면서도 대사증후군, 낙상, 일상생활 기능 저하의 위험이 높지만 외형만으로는 위험군으로 식별되지 않는다. 따라서 노인 체형 연구는 단순히 외형을 유형화하는 데 그치지 않고, 신체 비율 지표가 내포한 건강 위험 정보를 함께 규명할 때 비로소 실질적 활용 가치를 가진다.
또한 신뢰할 수 있는 노인 체형 분류 체계는 단순한 학술적 관심을 넘어 사회적 파급력을 가진다. 고령자의 신체 비례에 맞지 않는 의류와 보조 기기는 착용감 저하와 안전사고로 이어질 수 있으며, 표준 치수의 부재는 산업계가 고령 소비자를 위한 제품을 설계할 때 근거 자료의 공백을 의미한다. 따라서 한국 노인의 실측 자료에 기반한 체형 분류와 핵심 지표의 규명은 의류·복지·보건 분야 전반의 설계 기준 정비에 기초가 된다. 나아가 이러한 체형 원형은 물리적 제품 설계에 그치지 않고 디지털 환경에서의 인체 표현과 직결된다. 온라인 의류 구매의 가상 피팅, 고령자 대상 3D 아바타 생성, 체형 기반 사이즈 추천 등은 모두 대상 집단의 신체 비례를 수치로 규정한 기준 체형을 입력으로 요구하지만, 현행 아바타·피팅 시스템의 기준 체형은 청장년층 계측치에 기반하고 있어 노인의 체형 특성을 반영하지 못한다. 본 연구가 도출하는 원형 체형과 핵심 비율 지표는 이러한 디지털 인체 표현의 파라미터 기준을 노인 집단에 맞게 보정하는 데 활용될 수 있다.
이러한 한계를 극복하기 위해서는 신체 계측값에 기반한 정량적 접근이 필요하다. 따라서 허리둘레/키 비율(WHtR), 허벅지 및 가랑이 높이(Thigh/Crotch Height) 비율 등 다차원 신체 비율 지표를 활용한 군집 분석은 시각적 판단의 한계를 보완하여, 외형적으로 유사해 보이는 노인들 사이에서도 대사 위험 수준이 다른 체형 유형을 객관적으로 분류하고 그 위험성을 제시할 수 있다. 따라서 본 연구는 한국 노인 체형 표준화를 위한 기초 연구로서, 한국 노인 주요 신체 비율 지표에 대한 성별·연령대별 통계적 유의성을 제시하고, 군집 모델의 성능 비교를 통해 노인의 체형 위험성을 정량적으로 규명하고자 한다.
위의 목적을 바탕으로 본 연구는 다음 세 가지 연구 문제에 답하고자 한다. 첫째, 한국 노인의 주요 신체 비율 지표는 성별과 연령대에 따라 어떠한 통계적 분포 특성을 보이는가. 둘째, 서로 다른 원리에 기반한 군집 방법들은 동일한 자료에서 어떤 체형 구조를 도출하며, 그중 한국 노인 체형의 원형(Prototype)을 가장 타당하게 식별하는 방법은 무엇인가. 셋째, 도출된 체형 구조 및 건강 위험과 가장 강하게 연관되는 핵심 신체 비율 변수는 무엇이며, 그 연관성은 다른 변수를 통제한 뒤에도 일관되게 유지되는가. 다만 본 연구의 건강 위험 준거가 일부 비율 지표에서 파생된 복합 점수라는 점에서, 이 검증은 완전한 의미의 독립적 예측력 확인이 아니라 지표 간 정합성 확인을 목표로 한다. 이를 통해 본 연구는 향후 한국 노인 특화 체형 분류 체계와 맞춤형 설계 기준 수립에 필요한 통계적·방법론적 기초 자료를 제공하는 데 기여하고자 한다.
본 연구는 체형의 분류와 검증을 분리하여 접근한다는 점에서 특징을 가진다. 먼저 비지도 군집 분석으로 자료에 내재한 체형 구조를 탐색하고, 이어 그 구조와 핵심 변수가 건강 위험과 통계적으로 유의하게 연결되는지를 독립적으로 검증한다. 이러한 설계는 군집 결과의 자의성을 줄이고, 도출된 체형이 실제 건강상의 의미를 가지는지를 객관적으로 평가할 수 있게 한다.
Ⅱ. 연구방법
2-1 데이터 수집
본 연구에서는 노인 체형의 구조를 도출하기 위해 사이즈코리아에서 제공하는 인체 계측 조사에서 65세 이상 한국 노인 1,381명(남성 657명, 여성 724명, 평균 71.2±5.1세)을 분석하였다. 65세 이상의 연령대 분포는 65~69세 54.5%, 70~74세 26.3%, 75~79세 14.5%, 80세 이상 4.7%였다.
사이즈코리아는 국가기술표준원이 주관하는 국가 인체치수 조사로, 표준화된 계측 프로토콜에 따라 직접 계측(Direct Measurement) 방식으로 신체 치수를 수집한다. 본 연구는 이 가운데 65세 이상 노인의 직접 계측 항목을 활용하였으며, 분석에 필요한 둘레·길이·높이 항목이 모두 확보된 사례를 대상으로 하였다. 연령 분포에서 확인되듯 표본의 다수가 65~74세에 집중되어 있어, 초고령 구간(80세 이상)의 표본 수가 상대적으로 적다는 점은 결과 해석 시 고려할 필요가 있다.
표본은 성별 간 규모가 비교적 균형을 이루어(남성 657명, 여성 724명) 성별 비교에 필요한 통계적 검정력을 확보하였다. 또한 단일 조사 체계에서 동일한 프로토콜로 수집된 자료를 사용함으로써, 서로 다른 조사 간 계측 방식의 차이에서 비롯되는 측정 편향을 최소화하였다.
2-2 분석 변수 선정
체형 분류의 타당성을 높이기 위해 신장의 영향을 제거한 10개 비율 지표를 주요 분석 변수로 선정하였다. 10개 비율 지표를 도출하기 위해 총 1,381명의 신체 계측 데이터를 활용해 WHtR (Waist/Height), Hip/Height, Thigh/Crotch Height, Calf/Thigh, Calf/Height, Upper Arm/Height, Thigh/Height, Shoulder Width/Height, Crotch Height/Height, Upper Arm Length/Height에 대한 변수를 만들었고, 복합 건강 위험 점수(WHtR Abdominal Obesity + AWGS Sarcopenia Risk + 하체 근육 부족)를 종속 변수로 활용하여 체형 분류의 건강 관련 타당성을 검증하였다.
비율 지표는 모두 분자 계측치를 신장 또는 관련 기준 계측치로 나누어 산출하였다. 신장으로 표준화한 지표(WHtR, Hip/Height, Upper Arm/Height, Thigh/Height, Shoulder Width/Height, Crotch Height/Height, Upper Arm Length/Height, Calf/Height)는 개인 간 키 차이에서 비롯되는 절대 치수의 변동을 제거하여, 체격이 다른 노인들의 체형을 동일한 기준에서 비교할 수 있게 한다. 한편 Thigh/Crotch Height와 Calf/Thigh는 하지 내부의 상대적 비례를 나타내어, 단순한 굵기가 아니라 하지의 형태적 구조를 반영한다.
종속 변수로 사용한 복합 건강 위험 점수는 세 가지 위험 요소를 결합하여 구성하였다. 첫째는 WHtR을 기준으로 한 Abdominal Obesity 여부, 둘째는 노인 근감소증 진단 기준(AWGS)에 근거한 Sarcopenia Risk, 셋째는 하체 근육량 부족이다. 각 요소의 충족 여부를 합산하여 위험 수준을 단계화하였으며, 이는 체형 분류 결과가 단순한 형태적 구분에 그치지 않고 건강 위험과 연결되는지를 검증하기 위한 준거로 활용되었다. 복합 건강 위험 점수의 구체적 산출 기준은 표 1에 정리하였다.

Composite health risk score
열 개의 비율 지표를 동시에 활용한 것은 단일 지표가 포착하지 못하는 다차원적 체형 특성을 반영하기 위함이다. 다만 변수 간 측정 단위와 분산이 상이하므로, 군집 분석에 앞서 모든 변수를 평균 0, 표준편차 1로 표준화하여 특정 변수가 거리 계산에서 과도한 영향을 미치지 않도록 하였다. 아울러 분모가 비정상적으로 작은 값으로 인해 비율이 왜곡되는 사례가 없도록 점검하여, 극단값이 군집 형성에 과도한 영향을 미치는 것을 방지하였다.
2-3 군집 방법 비교
10개의 비율 변수와 성별 더미를 StandardScaler로 표준화한 후 5가지 군집 방법을 k=3~5 범위에서 비교하였다. 5가지 모델에는 K-means[8], 가우시안 혼합 모델(GMM), 병합 군집화(Agglomerative Clustering), Noise를 포함한 데이터에 대해 밀도 기반으로 클러스터링해 데이터가 밀집되어 있는 집합의 판단을 위해 Density-Based Spatial Clustering Of Applications with Noise(DBSCAN)[9], Autoencoder+K-means(AE+K-means)[10]을 통해 모델의 학습을 진행했다. 모델의 군집의 성능 지표로 Silhouette Coefficient[11]와 Davies-Bouldin Index[12]를 사용하였다. DBSCAN은 Epsilon과 Min_samples(최소 표본 수)를 탐색하여 노이즈 제외 군집 수가 3·4·5개가 되는 지점을 선택해 동등 비교하였다[13].
성별 더미는 여러 신체 비율 지표(특히 Thigh/Crotch Height, Calf/Thigh)와 강하게 연관되므로, 군집이 체형 구조가 아니라 성별 차이를 반영할 가능성이 있다. 이를 검토하기 위해(a) 성별 더미를 포함한 경우와(b) 성별 더미를 제외한 경우 두 조건에서 동일한 5가지 군집 방법을 반복 수행하고, 두 조건에서 도출된 군집 구성의 일치도(Adjusted Rand Index; ARI, Normalized Mutual Information; NMI)와 각 군집의 성별 구성 비율을 비교하는 민감도 분석을 실시하였다. 이 분석의 결과는 3-2-1절과 표 8에 제시하였다. Autoencoder + K-means의 구조를 살펴보면 인코더는 입력 비율 지표를 저차원 잠재 공간으로 압축하고 디코더가 이를 대칭 구조로 복원하도록 구성하였으며, 활성화 함수는ReLU, Optimizer는 Adam, 손실 함수는 평균제곱오차(MSE)의 기본 조합을 사용하였다. 학습은 batch size 64로 수행하였고, 이후 학습된 잠재 공간에 K-means를 적용하여 최종 군집을 산출하였다.
다섯 가지 군집 방법은 서로 다른 가정과 원리에 기반한다. K-means는 군집 중심으로부터의 거리를 최소화하여 구형(Spherical)의 등방적 군집을 가정하며 계산이 빠르고 해석이 용이하다. 가우시안 혼합 모델(GMM)은 각 군집을 정규분포로 모형화하여 타원형의 군집과 소속 확률을 허용한다. 병합 군집화(Agglomerative)는 개체를 점진적으로 병합하는 위계적 방법으로, Ward 연결법은 병합 시 군집 내 분산의 증가가 최소가 되도록 한다. DBSCAN은 밀도에 기반하여 임의 형태의 군집을 찾고 밀도가 낮은 영역의 개체를 노이즈로 분리한다. Autoencoder+K-means(AE+K-means)는 신경망으로 자료를 저차원 잠재 공간으로 압축한 뒤 그 공간에서 K-means를 적용하는 방법이다.
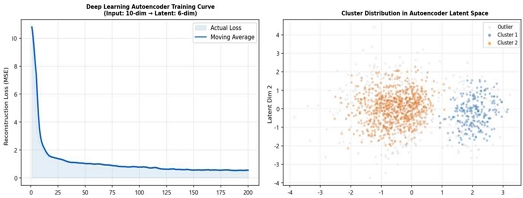
이 가운데 Autoencoder는 입력층의 비율 지표를 인코더를 통해 저차원 잠재 벡터로 압축한 뒤, 디코더가 이를 다시 원래 차원으로 복원하도록 학습된다. 복원 오차를 최소화하는 과정에서 자료의 주요 변동을 보존하는 잠재 표현이 형성되며, 본 연구는 이 잠재 공간에 K-means를 적용하여 선형 기법이 포착하기 어려운 비선형 구조까지 반영한 군집을 탐색하고자 하였다. 재현 가능성을 위해 신경망 구조와 학습 설정을 구체적으로 기술하면 다음과 같다. 입력층은 10개의 비율 지표와 성별 더미를 합한 11차원이며, 인코더는 11-32-16-2의 완전연결 구조로 차원을 축소하고 디코더는 2-16-32-11의 대칭 구조로 입력을 복원하도록 구성하였다. 잠재 차원을 2로 설정한 것은 군집 구조를 추가적인 차원 축소 없이 그대로 시각화하기 위한 것으로, 그림 2(우)와 그림 6(우)에 제시한 잠재 공간 산점도는 이 2차원 잠재 벡터를 그대로 도시한 것이다. 은닉층의 활성화 함수는 ReLU를 사용하였고 출력층에는 선형 활성화를 적용하였다. 손실 함수는 평균제곱오차(MSE), 최적화 알고리즘은 Adam(learning rate 0.001)을 사용하였으며, batch size 64로 최대 200 epoch 학습하되 검증 손실이 20 epoch 동안 개선되지 않으면 조기 종료하도록 하였다. 전체 표본은 8:2 비율로 학습 집합과 검증 집합으로 분할하였고, 가중치 초기화와 표본 분할에 사용한 난수 시드는 42로 고정하여 동일 조건에서 결과가 재현되도록 하였다. 학습은 조기 종료 조건에 따라 181 epoch에서 종료되었으며, 종료 시점의 재구성 오차(MSE)는 학습 집합 0.1427, 검증 집합 0.1539였다. 따라서 두 값의 차이가 작아 과적합은 관찰되지 않았다.
군집 결과의 품질은 두 가지 내적 타당도 지표로 평가하였다. Silhouette Coefficient는 각 개체가 자신이 속한 군집과 가장 가까운 다른 군집에 대해 얼마나 잘 분리되어 있는지를 나타내며, 값이 클수록 응집도와 분리도가 우수함을 의미한다. Davies-Bouldin Index는 군집 내 산포 대비 군집 간 거리의 비율을 평균한 값으로, 값이 작을수록 군집이 잘 분리되어 있음을 뜻한다. 두 지표를 함께 사용함으로써 특정 지표의 편향에 의존하지 않고 방법 간 성능을 균형 있게 비교하였다.
군집 수를 k=3에서 5까지로 제한한 것은, 체형 분류 결과가 설계·생산 현장에서 실제로 활용되려면 지나치게 세분화되지 않은 해석 가능한 수의 유형으로 요약되어야 한다는 실용적 고려에 따른 것이다. 특히 군집 수 범위(k=3~5)는 통계적 기준으로 실루엣 계수를 최대화하는 k에 따라 정한 것이 아니라, 신체 사이즈 분류 체계의 실용적 세분성에 근거하여 결정하였다. 군집이 2개이면 체형을 지나치게 단순화하여 실제 치수 구분에 필요한 변별력을 확보하기 어렵고, 6개 이상이면 사이즈 체계로 운용하기에 지나치게 세분화되어 생산·관리 효율이 떨어진다고 판단하였다. 즉 k=3~5는 통계적 최적화의 산물이라기 보다 의류·용품 사이즈 분류에서 실용적으로 수용 가능한 유형 수를 고려하여 해당 k의 범위로 군집 분석을 진행했다. 밀도 기반 방법인 DBSCAN은 군집 수를 직접 지정하지 않는 대신 이웃 반경(Epsilon)과 최소 표본 수(Min_samples)에 의해 군집이 형성되므로, 노이즈를 제외한 군집 수가 다른 방법과 동일하게 3·4·5개가 되는 매개변수 조합을 탐색하여 공정한 비교가 가능하도록 하였다. 한편 원형 체형 도출에는 위와 다른 목적이 적용된다. 표 3의 세 조합이 타 방법과의 공정 비교를 위해 군집 수를 3·4·5로 맞춘 것인 데 반해, 원형 체형 도출에서는 군집 수를 사전에 고정하지 않고 밀도 핵심부가 안정적으로 분리되는 조합을 탐색하였다. 이때 입력은 10개 비율 지표만으로 구성하였으며, 성별 더미는 포함하지 않았다. 성별 더미를 포함하면 표준화 공간에서 성별이 하나의 축을 이루어 밀도 구조를 양분하므로, 노이즈를 제외한 군집이 2개가 되는 조합에서 노이즈 비율이 최소 87.0%까지 치솟아 원형 추출이 불가능하였다. 탐색은 Epsilon 1.00~1.60(0.01 간격), Min_samples 5~40(1 간격)의 격자에서 수행하였고, 각 조합에 대해 노이즈 제외 군집 수, 노이즈 비율, 핵심부 실루엣, 전체 표본 기준 실루엣을 산출하였다. 선택 기준은 (i) 노이즈 제외 군집 수가 2개로 안정적으로 유지되고, (ii) 인접 매개변수 값의 미세한 변화에도 군집 배정이 크게 바뀌지 않으며, (iii) 노이즈 비율이 표 3의 세 조합보다 실질적으로 낮은 조합이었다. 그 결과 Epsilon=1.25, Min_samples=15를 최종 채택하였으며, 이 조합에서의 노이즈 비율(Transitional Type)은 24.9%, 핵심부 실루엣은 0.459였다. 이 조합이 국소적 우연이 아님은 인접 구간의 안정성으로 확인된다. Epsilon 1.18~1.44, Min_samples 9~40에 걸친 89개 조합이 모두 동일하게 2개의 핵심 군집을 산출하였으며, 이 구간 전체에서 노이즈 비율은 23.0~26.9%, 핵심부 실루엣은 0.450~0.465의 좁은 범위에 머물렀다. 즉 매개변수를 상당 폭으로 변화시켜도 동일한 밀도 구조가 반복 관찰된다.
2-4 통계적 유의성 검증
성별 비교는 Mann-Whitney U 검정(효과 크기 r), 연령대별(5세 구간) 비교는 Kruskal-Wallis 검정(η2)을 적용하였다. 복합 위험 점수와의 관련성은 Spearman 상관계수(ρ)로 분석하였다. 체형 분류 핵심 변수와 복합 건강 위험 점수 간의 정합성은 이항 로지스틱 회귀(OR, 95% CI, McFadden R2)로 정량화하였다. 종속 변수인 복합 위험 점수가 일부 예측 변수와 파생 관계에 있으므로, 이 회귀는 정합성 확인으로 해석한다.
본 연구는 신체 비율 지표의 분포가 정규성을 충족하지 않을 가능성을 고려하여 비모수 검정을 채택하였다. 성별 간 차이는 Mann-Whitney U 검정으로 검정하고 효과 크기 r로 차이의 크기를 함께 보고하였으며, 세 개 이상의 연령대 간 차이는 Kruskal-Wallis 검정과 효과 크기로 평가하였다. 변수 간 관련성은 단조 관계를 가정하는 Spearman 상관계수로 분석하였다. 또한 여러 변수를 동시에 고려했을 때 각 변수의 독립적 기여를 확인하기 위해 이항 로지스틱 회귀를 적용하고, 오즈비와 95% 신뢰구간, McFadden R2로 모형의 설명력을 제시하였다. 다수의 지표를 반복 검정함에 따라 발생할 수 있는 1종 오류의 누적을 통제하기 위해 Bonferroni 보정을 적용하였다. 로지스틱 회귀에서 Thigh/Crotch Height와 Calf/Thigh의 오즈비가 0에 수렴하고 계수가 극단적으로 추정되어(β≈−42~−44), 준완전분리(Quasi-Complete Separation)의 가능성이 확인되었다. 이에 (1) 각 예측 변수의 분산팽창지수(VIF)로 다중공선성을, (2) 일반화선형모형에서 최대우도 추정치의 존재 여부, 즉 완전/준완전 분리 여부를 진단하였고[21], (3) 표준 최대우도 추정의 불안정을 보완하기 위해 Firth 벌점화 로지스틱 회귀[22]를 추가로 적합하여 계수·표준오차·벌점화 오즈비와 신뢰구간을 함께 보고하였다. 분리 진단·Firth 회귀·VIF 결과는 표6에 별도로 제시하였다. 준완전분리가 확인된 경우 표준 최대우도 추정치는 유한한 값으로 수렴하지 않아 효과 크기와 신뢰구간을 신뢰할 수 없으므로, 본 연구는 표 6의 Firth 벌점화 추정치를 핵심 변수 해석의 주 기준으로 삼고, 표 5의 표준 회귀 결과는 분리 현상 자체를 드러내는 진단 근거이자 분석 투명성 확보를 위한 참고 자료로 제시한다.
Ⅲ. 결 과
3-1 주요 신체 비율 지표의 통계적 특성
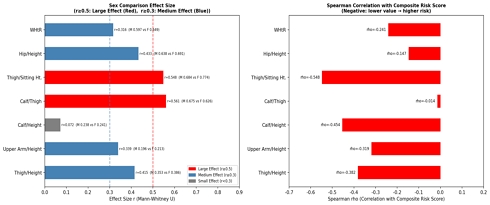
표 2는 핵심 신체 비율 지표의 성별 기술통계와 Mann-Whitney U 검정 결과이다. 두 개의 지표인 Thigh/Crotch Height(남성 0.684, 여성 0.774; r=0.548)와 Calf/Thigh(남성 0.675, 여성 0.626; r=0.561)가 대(Large) 효과 크기로 성별 체형 차이를 나타냈다. WHtR(r=0.316), Hip/Height(r=0.433)는 중간(Medium) 효과 크기를 보였다. Shoulder Width/Height는 남녀 동일(0.256)로 안정적 비율임이 확인되었다. 표 2의 결과를 살펴보면 세 지표 가운데Crotch Height/Height만 소(Small) 효과 크기(r=.237)를 보였고, Calf/Height와 Upper Arm Length/Height는 유의한 성별 차이가 없었다. 즉 10개의 변수들중 Calf/Height, Crotch Height/Height, Upper Arm Length/Height는 지표는 성별 변별력이 낮아 본문 해석에서 비중이 작았음을 확인할 수 있다.
Body ratio comparison by gender
이러한 결과는 한국 노인의 성별 체형 차이가 주로 하지의 형태에서 비롯됨을 보여준다. 여성에서 Thigh/Crotch Height 비율이 더 높게 나타난 것은 동일한 다리 길이에 비해 넙다리 둘레가 상대적으로 크다는 의미로, 하체에 지방이 축적되는 여성 특유의 체지방 분포 양상과 일치한다. 반대로 Calf/Thigh 비율이 남성에서 더 높게 나타난 것은 남성의 하지 근육이 장딴지까지 비교적 고르게 분포함을 시사한다. 두 지표 모두 대(Large) 효과 크기를 보였다는 점은, 성별이 노인 체형 분류에서 우선적으로 고려되어야 할 층화 변수임을 통계적으로 뒷받침한다. 반면 Shoulder Width/Height 비율이 성별에 관계없이 동일하게 나타난 것은, 골격 구조에서 기인하는 상체 가로 비율이 연부 조직 변화의 영향을 적게 받는 안정적 지표임을 의미한다.
표 2에서 Medium 효과 크기를 보인 지표들도 일관된 방향성을 나타냈다. WHtR(남성 .558, 여성 .592), Hip/Height(남성 .614, 여성 .661), Upper Arm/Height(남성 .190, 여성 .202), Thigh/Height(남성 .350, 여성 .383)는 모두 여성에서 더 높은 값을 보였는데, 이는 여성이 동일 신장 대비 둘레 계측치가 상대적으로 크다는 점을 반영한다. 이러한 중간 수준의 차이가 여러 지표에서 동시에 관찰된다는 사실은, 성별이 특정 부위에 국한되지 않고 전신적 비율에 영향을 미침을 보여준다.
연령대별 어떠한 부위가 가장 영향을 많이 받는 신체 값들인지를 판단하기 위해 Kruskal-Wallis로 비교한 결과를 살펴보면 Hip/Height(H=159.5, η2=0.113)가 가장 강한 연령 효과를 나타냈으며, WHtR(H=97.5, η2=0.068)도 유의하였다. 반면 Calf/Thigh는 연령 간 유의한 차이가 없었다(H=2.93, p=.570). 즉 하지 내 장딴지–넙다리 비율은 연령의 영향을 받지 않는 안정적인 체형 구조 지표임이 시사된다.
연령대별 분석 결과는 노인 체형의 변화가 부위에 따라 상이한 속도로 진행됨을 보여준다. Hip/Height와 WHtR이 연령에 따라 유의하게 변화한 것은, 노화가 진행될수록 복부와 둔부를 중심으로 체지방 재분포가 누적된다는 점을 반영한다. 반면 Calf/Thigh 비율이 연령 간 차이를 보이지 않은 것은, 이 지표가 특정 시점의 체지방 변화보다 하지 근육의 구조적 비례를 반영하기 때문으로 해석된다. 따라서 이 비율은 연령 보정 없이도 비교적 안정적으로 활용할 수 있는 체형 분류 지표로서의 잠재력을 가진다.
3-2 군집 방법 성능 비교 및 최적 방법 선정
표 3과 그림 1은 5가지 군집 방법을 동일한 군집 수(k=3, 4, 5) 조건에서 비교한 결과이다. DBSCAN은 모든 k 조건에서 높은 Silhouette Coefficient와 낮은 Davies-Bouldin Index를 나타냈으나 Noise Ratio가 49~74%로 과도하였다. 표 3에 제시된 DBSCAN의 실루엣 계수(k=3에서 .514)는 표본의 상당 부분을 노이즈로 제외한 뒤 남은 핵심부만을 대상으로 산출된 값이므로, 노이즈 제외에 따른 상향 편의가 존재한다. 따라서 본 연구는(a) 노이즈를 제외한 핵심부 기준 실루엣과(b) 노이즈를 하나의 집단으로 간주하여 전체 표본을 대상으로 산출한 실루엣을 구분하여 해석하였다. 실제로 노이즈를 하나의 집단으로 간주하여 전체 표본을 대상으로 실루엣을 재산출하면, 표 3의 DBSCAN 세 조합은 각각 k=3에서 -0.159, k=4에서 -0.015, k=5에서 -0.156으로 모두 음수가 된다. 즉 표 3에서 DBSCAN이 보이는 우위는 노이즈로 분리된 표본을 평가에서 제외한 결과이며, 노이즈를 포함하면 오히려 전수 분류 방법들보다 낮은 값을 보인다. 이는 DBSCAN을 전체 표본을 가장 잘 분류하는 방법으로 해석해서는 안 되며, 밀도 핵심부의 전형적 형태를 추출하는 탐색적 도구로 한정해 해석해야 함을 뜻한다. 한편 3-3에서 원형 체형 도출에 채택한 설정(Epsilon=1.25, Min_samples=15)의 경우 전체 표본 기준 실루엣은 0.228로 양수를 유지하여, 표 3의 세 조합보다 전체 표본에 대한 설명력이 높았다. 전체 표본을 빠짐없이 분류하는 방법 중에서는 K-means k=4가 가장 안정적이었다. 하지만 해당 모델은 실루엣 점수가 낮기 때문에 제대로 된 군집 결과를 도출하기 어렵다. 따라서 본 연구에서는 DBSCAN이 노이즈로 분류한 영역을 군집 경계의 Transitional Type으로 재해석하고 이를 분리함으로써, 밀도 핵심부를 원형 체형으로 추출하는 DBSCAN 기반 접근의 타당성을 확보하였다.
Comparison of performance metrics by cluster method × number of clusters (k)
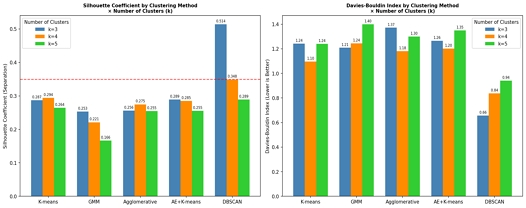
Comparison of silhouette coefficient and Davies-Bouldin index by cluster method × number of clusters (k=3,4,5)
이 결과는 군집 방법의 선택이 평가 기준에 따라 상반된 결론으로 이어질 수 있음을 보여준다. DBSCAN은 밀도가 높은 핵심 영역만을 군집으로 인정하고 경계가 모호한 표본을 노이즈로 분리하기 때문에, 군집 내 응집도와 군집 간 분리도를 측정하는 Silhouette Coefficient와 Davies-Bouldin Index에서 가장 우수한 값을 보인다. 그러나 전체 표본의 절반 이상을 노이즈로 처리하는 것은 모든 개체를 분류 대상으로 삼아야 하는 표준 체형 분류의 목적과 상충한다. 반대로 K-means 계열 방법은 모든 표본을 빠짐없이 군집에 배정하지만, 그 대가로 군집 간 경계가 불분명해져 Silhouette Coefficient가 낮게 나타난다. 본 연구는 이 상충 관계를 절충하기 위해, DBSCAN이 노이즈로 분류한 영역을 단순한 측정 오류가 아니라 두 체형 사이의 연속적 전환 구간으로 재해석하는 전략을 채택하였다.
표 3에서 확인되듯, 전체 표본을 모두 분류하는 K-means, GMM, Agglomerative, AE+K-means는 Noise Ratio가 0%인 대신 Silhouette Coefficient가 대체로 0.3 미만에 머물렀다. 이는 노인 신체 비율 자료가 명확히 분리된 군집보다 연속적으로 이어진 분포 형태에 가깝다는 점을 시사한다.
표 3의 DBSCAN 실루엣은 노이즈 제외 핵심부 기준값이다. 3-3의 원형 체형 도출에 사용한 DBSCAN 설정은 위 세 조합과 다르며, 이는 두 실험의 목적이 다르기 때문이다. 표 3은 타 군집 방법과의 공정한 성능 비교를 위해 군집 수를 3·4·5로 강제로 맞춘 결과이고, 3-3은 군집 수를 고정하지 않고 밀도 핵심부의 안정적 분리를 기준으로 매개변수를 선택한 결과이다(선택 절차는 2-3절, 격자 탐색 결과는 표 7 참조). 따라서 최종 설정에서의 노이즈(Transitional Type) 비율은 24.9%로, 표 3의 세 조합(49.0~74.3%)보다 실질적으로 낮다. 따라서 최종 설정에서의 노이즈(Transitional Type) 비율은 24.9%로, 표 3의 세 조합(49.0~74.3%)보다 실질적으로 낮다.
군집화 입력에 성별 더미를 포함할 경우 군집이 체형 구조가 아니라 성별 차이를 반영할 수 있다는 우려에 대응하여, 성별 더미 포함(a) 조건과 제외(b) 조건에서 동일한 군집 방법을 반복 수행하고 두 조건의 군집 구성을 비교하였다(표 8). 조건 간 일치도는 K-means에서 ARI 0.801(k=3), 0.741(k=4), 0.706(k=5), NMI 0.787, 0.776, 0.762였고, GMM에서 ARI 0.925(k=3), 0.295(k=4), 0.727(k=5), Agglomerative에서 ARI 0.610(k=3), 0.518(k=4), 0.440(k=5)이었다. 즉 중심 기반 방법인 K-means는 성별 더미의 포함 여부와 무관하게 대체로 동일한 군집 구조를 산출한 반면, 밀도·연결 기반 방법은 상대적으로 민감하였다.
다만 본 연구의 원형 체형은 성별 더미를 제외한 10개 비율 지표만으로 도출되었으므로, 원형 체형 자체가 성별 정보를 입력으로 받은 바 없다. 따라서 두 원형이 성별 더미에 의해 인위적으로 생성되었을 가능성은 구조적으로 배제된다. 그럼에도 성별 더미 제외 조건에서 도출된 군집의 성별 구성은 Type A 남 36.4%/여 63.6%, Type B 남 52.1%/여 47.9%, Transitional Type 남 44.2%/여 55.8%로 집단 간 차이를 보였다. 이는 성별 변수를 투입해서가 아니라, 하지 비율 지표(Thigh/Crotch Height, Calf/Thigh)에 내재한 체형의 성차가 밀도 구조에 그대로 반영된 결과로 해석된다. 즉 성별과 체형 구조는 인위적으로 결합된 것이 아니라 실제로 연관되어 있다 할 수 있다.
3-3 원형 체형(Prototype Body Types) 식별
전수 분류 기준에서는 K-means k=4가 최적이었으나, 밀도 핵심부를 군집으로, 경계 영역을 Transitional Type으로 분리하는 DBSCAN의 특성은 가장 전형적인 체형의 윤곽을 드러내는 탐색적 목적에 더 적합하다. 다만 이 접근은 표본의 일부를 경계 영역으로 남긴 채 남은 핵심부로 원형을 정의하므로, 아래에서 도출하는 두 원형은 한국 노인 체형 전체를 대표하는 확정적 구조가 아니라 밀도 핵심부에서 관찰된 탐색적 원형으로 한정하여 해석해야 한다. DBSCAN이 가장 안정적으로 분할한 결과(핵심 원형 2개 + Transitional Type 24.9%, 핵심부 실루엣 0.459)를 바탕으로 두 개의 원형 체형과 Transitional Type 집단을 식별하였다(표 4, 그림 2).
Comparison of key features by prototype body type
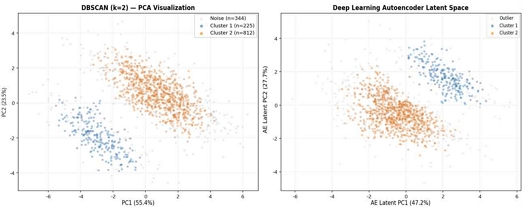
DBSCAN prototype body type PCA visualization (left) and Autoencoder latent space (right)
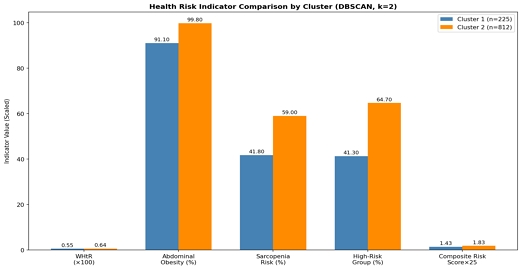
Type A: Lower-Risk/Preserved-Limb Type(저위험·하지비례 보존형, n=225, 16.3%): 여성 비율이 높고(여 63.6%) WHtR(0.554)이 상대적으로 낮으며 Abdominal Obesity 유병률은 91.1%이다. Sarcopenia Risk(41.8%)와 High-Risk Group 비율(41.3%)이 세 집단 중 가장 낮다. 2차 수정본까지 이 집단을 Balanced-Proportion Type으로 명명하였으나, 복부비만 유병률이 91.1%에 이르는 집단에 균형(Balanced)이라는 표현을 사용하면 독자가 이를 정상 체형 또는 저위험 체형으로 오독할 소지가 크다. 따라서 본 수정본에서는 이 집단의 실제 데이터 특성, 즉 (i) 세 집단 중 가장 낮은 복합 위험도와 (ii) 상대적으로 보존된 하지 비례를 직접 반영하는 Lower-Risk/Preserved-Limb Type으로 명칭을 확정하고 본문·표·그림 전반에 일관되게 적용하였다. 여기서 저위험은 절대적 저위험이 아니라 세 집단 간 상대적 비교에서의 최저 위험을 뜻한다.
Type B: Abdominal-Protrusion Type(n=812, 58.8%): 남녀 혼합(남 52.1%)이며 WHtR(0.641)이 높고 Abdominal Obesity 유병률이 99.8%에 달한다. Sarcopenia Risk(59.0%)와 고위험 비율(64.7%) 모두 Type A보다 높았다.
Transitional Type (n=344, 24.9%)는 두 체형의 특성이 혼재하는 경계 집단이다. 여기서 Transitional Type은 DBSCAN이 노이즈로 분리한 밀도 경계 영역을 가리키며, 통계적 이상치(Outlier)와는 의미가 다르므로 본 논문 전반에서 Transitional Type(경계형)으로 나타냈다. 집단별 건강 위험 지표는 그림 3에 제시하였다.
Comparison of health risk indicator profiles by prototype body type
두 원형 체형은 단순한 군집 크기 차이를 넘어 건강 위험 수준에서도 뚜렷이 구분된다. Lower-Risk/Preserved-Limb Type(Type A)은 Abdominal Obesity 유병률이 높음에도 불구하고 Sarcopenia Risk와 High-Risk Group 비율이 상대적으로 낮아, 비교적 보존된 하지 근육이 대사 위험을 일부 완충하는 양상을 보인다. 반면 Abdominal-Protrusion Type(Type B)은 Abdominal Obesity가 거의 전원에서 관찰되는 동시에 Sarcopenia Risk와 High-Risk Group 비율이 모두 높아, 복부 지방 축적과 근육 감소가 함께 진행된 고위험 체형으로 해석된다. 전체 표본의 약 4분의 1을 차지하는 Transitional Type 집단이 두 체형의 중간 수준 위험도를 보인다는 점은, 노인 체형이 명확히 구분되는 소수의 범주가 아니라 위험도가 점진적으로 변화하는 연속선상에 분포함을 시사한다.
표 4에 제시된 세부 지표를 살펴보면, 세 집단은 WHtR, Thigh/Crotch Height, Calf/Thigh의 평균값에서 일관된 순서를 보인다. Abdominal-Protrusion Type은 Abdominal Obesity와 관련된 지표에서 가장 높은 값을, Lower-Risk/Preserved-Limb Type은 가장 낮은 값을 나타내며, Transitional Type은 두 집단의 중간에 위치한다. 이러한 단계적 배치는 세 집단이 질적으로 단절된 범주가 아니라 동일한 연속선 위의 서로 다른 구간에 해당함을 수치적으로 뒷받침한다.
세 집단의 인구통계학적 구성에서도 차이가 관찰되었다. Lower-Risk/Preserved-Limb Type은 여성 비율이 63.6%로 가장 높았던 반면, Abdominal-Protrusion Type은 남성 비율이 52.1%로 상대적으로 높아, 복부 중심의 지방 축적이 남성에서 더 두드러지는 경향과 부합한다. 평균 연령은 Lower-Risk/Preserved-Limb Type, Abdominal-Protrusion Type, Transitional Type는 70 초반의 값을 가지며 큰 차이는 없었으나, 위험도가 높은 집단일수록 평균 연령이 다소 높아지는 경향을 보였다.
표 4에서 정리한 집단 구분이 특징 공간에서 실제로 어떻게 분리되는지는 그림 2에서 확인할 수 있다. 그림 2는 주성분 분석(PCA)으로 축약한 공간(좌)과 Autoencoder 잠재 공간(우)에서 두 원형 체형과 Transitional Type 집단의 분포를 나란히 대비하여 보여준다.
한편 이렇게 구분된 체형이 건강 위험과 어떻게 연결되는지는 그림 3에 정리하였다. 그림 3은 원형 체형별로 Abdominal Obesity, Sarcopenia Risk, High-Risk Group 비율 등 주요 건강 위험 지표의 프로파일을 비교하여, 체형 간 위험 수준의 차이를 직관적으로 드러낸다.
3-4 체형 분류 핵심 변수와 복합 건강 위험 점수 간 정합성
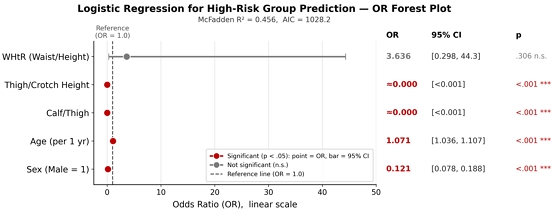
이항 로지스틱 회귀(McFadden R2=0.456)를 통해 체형 분류에 활용할 핵심 변수와 복합 건강 위험 점수 간의 정합성을 정량화하였다(표 5, 그림 4). High-Risk Group(복합위험점수 2~3점) 여부를 종속 변수로 활용하여 체형과 건강 위험의 관련성을 매개 검증 지표로 삼았다. 다만 종속 변수인 복합 위험 점수는WHtR 기반 복부비만과 하지(Calf/Thigh) 근육 부족 요소를 포함하므로, 동일 계열의 지표(WHtR·Calf/Thigh)를 예측 변수로 투입한 본 회귀는 부분적 순환성을 내포한다. 따라서 아래 결과는 완전히 독립적인 예측력 검증이라기보다 종속·예측 변수 간 정합성 확인에 가깝게 해석해야 하며, 임상·생화학 지표 등 파생 관계가 없는 외부 준거를 이용한 검증이 후속으로 필요하다.
Logistic regression results for predicting high-risk groups (based on related key variables)
Logistic regression Forest Plot: Odds ratio of key variables (OR=1.0 baseline)
Thigh/Crotch Height와 Calf/Thigh가 OR≈0(p<.001)으로 High-Risk Group과 가장 강한 역방향 연관을 보였다. 다만 앞서 밝힌 순환성으로 인해 이를 독립적 예측 변수로 규정하지 않으며, 복합 위험 점수를 구성하는 요소와 동일 계열의 비율 지표가 해당 위험 구조와 정합적으로 연결됨을 보여주는 결과로 해석한다. 이 두 지표는 Mann-Whitney U 검정, Spearman 상관, 로지스틱 회귀 세 분석에서 모두 일관되게 핵심 변수로 수렴되었다. 다만 두 지표의 OR이 0에 수렴하고 계수가 극단적(β≈−42~−44)이라는 점은 안정적으로 추정된 효과라기보다 준완전분리에 기인한 것이므로, Firth 벌점화 회귀 및 분리 진단 결과와 함께 해석하였다. 반면 WHtR은 표준 회귀에서 신뢰구간이 [.298–44.3]으로 매우 넓어 추정이 불안정하였다(OR=3.636, p=.306). 이 넓은 CI의 원인을 VIF·상관 구조로 점검한 결과 모든 예측 변수의 VIF가 2 미만으로 다중공선성은 크지 않았으므로(표 6), WHtR의 넓은 CI와 하지 비율 변수의 OR≈0은 주로 준완전분리에서 기인한다. 이에 준완전분리를 보정한 Firth 추정치(표6)를 주 해석 기준으로 삼으며, Firth 회귀에서 WHtR은 1 표준편차당 OR 2.47(95% CI [2.00, 3.05], p<.001)로 유의한 정방향 연관을 보였다. 따라서 WHtR은 하지 비율 변수보다 상대적 기여는 작으나 유의한 보조 지표로 해석한다. 성별(OR=0.121, p<.001)과 연령(OR=1.071/년, p<.001)은 각각 독립적인 체형 층화 변수로 확인되었다. 성별 효과 크기 및 복합 위험 점수와의 상관 구조는 그림 5에 제시하였다.
Separation diagnostics, Firth penalized logistic regression, and VIF for key predictors
Gender effect (left, r) and correlation with composite risk score (right, ρ)
주목할 점은 WHtR의 기여가 표준 회귀와 Firth 회귀에서 다르게 나타난다는 것이다. 표준 회귀에서는 넓은 신뢰구간으로 인해 유의하지 않았으나(p=.306) 이는 추정 불안정에 따른 것이며, 준완전분리를 보정한 Firth 회귀에서는 유의한 정방향 연관(OR 2.47, p<.001)으로 수렴하였다. 따라서 WHtR은 하지 비율 변수에 비해 상대적 기여가 제한적이지만 무의미하지는 않은 보조 지표로 해석하는 것이 타당하다. 세 가지 분석에서 일관되게 핵심 변수로 수렴한 Thigh/Crotch Height와 Calf/Thigh가 노인 체형과 건강 위험을 설명하는 데 더 본질적인 변수임을 뒷받침한다. 또한 성별과 연령은 복합 위험 점수와 파생 관계가 없는 변수임에도 유의한 연관을 유지하였는데, 이는 체형 분류 체계가 이 두 인구통계학적 변수를 층화 기준으로 우선 반영해야 함을 통계적으로 확인해 준다.
표 5의 결과를 종합하면, 모형의 McFadden R²는 0.456으로 범주형 결과를 예측하는 회귀에서 양호한 설명력에 해당한다. Thigh/Crotch Height와 Calf/Thigh의 오즈비가 0에 수렴한다는 것은 이들 지표가 클수록 High-Risk Group에 속할 확률이 급격히 낮아짐을 의미하며, 두 지표가 고위험 체형을 식별하는 강력한 보호적 방향의 변수임을 보여준다. 또한 연령이 1세 증가할 때 고위험 가능성이 약 7% 높아진다는 결과(OR=1.071)는 노화 자체가 독립적인 위험 요인으로 작용함을 나타낸다.
각 예측 변수의 역할을 구체적으로 살펴보면, Thigh/Crotch Height와 Calf/Thigh는 오즈비가 0에 가깝고 p<.001로 유의하여 High-Risk Group을 구분하는 핵심 변수로 작용하였다. 성별(남=1)의 오즈비는 .121로, 남성이 여성에 비해 해당 고위험 범주에 속할 확률이 낮음을 의미한다. 반면 WHtR은 오즈비 3.636에 신뢰구간이 [.298–44.3]으로 매우 넓고 p=.306으로 유의하지 않아, 단독으로는 안정적인 예측 변수로 기능하지 못함이 확인되었다.
McFadden R2=0.456/AIC=1028.2/OR≈0은 강한 음의 계수(β≈−42~−44)의 지수화 값 OR≈0은 준완전분리의 신호이므로, 분리 진단·Firth 벌점화 로지스틱 회귀·VIF를 표 6에 별도로 제시하여 추정의 안정성을 확보하였다.
연속 예측 변수는 1 표준편차 단위로 표준화하여 오즈비를 산출하였다(원 척도의 준완전분리로 인한 극단적 계수를 안정적으로 추정하기 위함). 복합 위험 점수는 복부비만(WHtR≥0.5), 근감소 위험(AWGS 종아리둘레 남<34·여<33 cm), 하지 근육 부족(성별 하위1/3 넙다리둘레)으로 조작화하였다.
모든 VIF가 2 미만으로 다중공선성은 심각하지 않으며, 따라서 표5의 OR≈0은 다중공선성이 아니라 준완전분리에서 기인한다. 표 5와 표 6을 대비하면 차이는 다음과 같다. 첫째, 방향성은 두 추정에서 완전히 일치한다. Thigh/Crotch Height와 Calf/Thigh는 표준 회귀와 Firth 회귀 모두에서 High-Risk Group에 대해 음의 방향(보호적 방향)으로 유의하였다. 둘째, 효과 크기의 안정성은 크게 달라진다. 표준 회귀에서 β≈−42~−44, OR≈0으로 해석 불가능하게 극단적이던 추정치가 Firth 회귀에서는 1 표준편차당 OR 0.058(Thigh/Crotch Height), 0.290(Calf/Thigh)의 유한하고 해석 가능한 값으로 수렴하였다. 셋째, WHtR의 결론이 달라진다. 표준 회귀에서 WHtR은 OR 3.636, 95% CI [.298–44.3], p=.306으로 유의하지 않았으나, 이는 넓은 신뢰구간이 시사하듯 추정 불안정에 따른 것이며, Firth 회귀에서는 OR 2.47, 95% CI [2.00, 3.05], p<.001로 유의한 양의 연관을 보였다. 따라서 본 연구는 앞서 밝힌 대로 Firth 추정치를 주 해석 기준으로 삼으며, 이에 근거하여 Thigh/Crotch Height와 Calf/Thigh는 복합 건강 위험과 강한 역방향 연관을, WHtR은 약하지만 유의한 정방향 연관을 가지는 것으로 해석한다. 이는 표준 회귀만을 근거로 WHtR을 ‘유의하지 않은 보조 지표’로 규정했던 2차 수정본까지의 서술을 수정하는 것으로, WHtR은 하지 비율 변수에 비해 설명력이 작으나 무의미하지는 않은 보조 지표로 위치시키는 것이 타당하다.
표 5의 회귀 결과를 시각적으로 요약한 것이 그림 4이다. 그림 4는 각 예측 변수의 오즈비를 기준선(OR=1.0)과 함께 표시한 Forest Plot으로, 핵심 변수들의 효과 방향과 신뢰구간을 직관적으로 비교할 수 있게 한다.
또한 그림 5는 앞선 분석 결과를 종합하여, 주요 비율 지표의 성별 효과 크기(좌)와 복합 위험 점수와의 상관(우)을 함께 제시한다. 이를 통해 여러 분석에서 동일한 핵심 변수가 일관되게 수렴하는 양상을 한눈에 파악할 수 있다.
Ⅳ. 논 의
4-1 핵심 변수 선정의 통계적 수렴성
본 연구의 가장 중요한 기여는 Thigh/Crotch Height와 Calf/Thigh가 원리가 서로 다른 세 가지 분석에서 일관되게 핵심 변수로 수렴함을 확인한 것이다. 다만 이 가운데 로지스틱 회귀는 종속 변수와의 파생 관계로 인해 정합성 확인의 성격을 가지므로, 수렴의 근거는 주로 성별 차이 검정과 상관 분석에 놓인다. 이 두 변수는 (1) Mann-Whitney U 검정에서 대(Large) 효과 크기(r=0.548, 0.561), (2) Spearman 상관에서 복합 위험 점수와의 강한 관련성(ρ=−0.548, -0.454), (3) 로지스틱 회귀에서 High-Risk Group과의 가장 강한 연관(p<.001)을 일관되게 나타냈다.
반면 WHtR은 표준 회귀에서는 넓은 신뢰구간으로 유의하지 않았으나(p=.306), 준완전분리를 보정한 Firth 회귀에서는 유의한 정방향 연관(OR 2.47, p<.001)을 보였다. 따라서 WHtR은 하지 비율 변수보다 상대적 기여가 제한적이지만 유의한 보조 지표이며, 향후 체형 분류 체계에서 하지 비율 두 변수를 주요 지표로, WHtR을 보조 지표로 활용하는 것이 타당함을 시사한다[14]-[17].
세 가지 서로 다른 원리의 분석(집단 간 차이 검정, 상관 분석, 다변량 회귀)에서 동일한 두 변수가 핵심으로 수렴했다는 점은 방법론적으로 중요한 의미를 가진다. 단일 분석에서 유의하게 나타난 변수는 그 분석의 가정이나 표본 특성에 의존할 수 있으나, 가정이 상이한 여러 분석에서 반복적으로 확인된 변수는 우연이나 특정 방법의 편향에 의한 결과일 가능성이 낮기 때문이다. Thigh/Crotch Height와 Calf/Thigh가 모두 하지의 형태를 반영하는 지표라는 점은, 노인의 체형 차이와 대사 위험이 상체보다 하지의 근육량 및 지방 분포와 더 밀접하게 연관되어 있음을 시사한다. 이는 근감소증이 사지 근육, 특히 하지에서 두드러지게 진행된다는 임상적 관찰과도 부합한다.
이러한 수렴적 증거는 체형 분류 변수를 선정할 때 단일 지표나 단일 분석에 의존하는 관행을 재고할 필요성을 제기한다. 특히 임상과 산업 현장에서 널리 사용되는 WHtR이 다변량 맥락에서는 하지 비율 변수보다 상대적 기여가 제한적이라는 본 연구의 결과는, 지표의 단변량 유의성만으로 그 지표를 주요 분류 기준으로 채택하는 것이 충분하지 않음을 보여준다. 따라서 향후 노인 체형 분류 체계는 서로 다른 통계적 접근에서 반복적으로 확인되는 변수를 우선적으로 채택하는 것이 바람직하다.
4-2 원형 체형의 의미와 한계
DBSCAN으로 추출한 두 원형 체형(Type A Lower-Risk/Preserved-Limb Type, Type B Abdominal-Protrusion Type)은 기존 노인 체형 연구[18]의 직통형과 Abdominal-Protrusion Type 체형 개념과 방향성이 일치하며, 표본에서 관찰된 결과이다. 다만 이는 밀도 핵심부에 해당하는 하위 표본에서 도출된 것이므로, 독립 표본을 통한 확인 전까지는 탐색적 결과로 다루어야 한다. Transitional Type이 24.9%(344명)에 달한다는 점은 이분법적 체형 분류가 한국 노인 체형 다양성을 충분히 포괄하지 못함을 시사한다.
Transitional Type 집단이 전체의 약 4분의 1에 이른다는 사실은 노인 체형 분류 체계 설계에 두 가지 시사점을 던진다. 첫째, 노인의 체형은 소수의 명확한 범주로 환원되기보다 두 극단적 원형 사이의 연속적 분포로 존재하므로, 이분법적 분류보다는 원형으로부터의 거리나 위험도의 정도를 함께 표현하는 단계적·연속적 분류가 더 적합할 수 있다. 둘째, Transitional Type 집단은 분류의 불확실성이 높은 만큼 건강 위험 선별에서 우선적으로 주의 깊게 평가되어야 할 대상이 될 수 있다. 외형이나 단일 지표로는 Lower-Risk/Preserved-Limb Type과 구분되지 않으면서도 Abdominal-Protrusion Type에 근접한 위험을 가진 개인이 이 집단에 포함될 수 있기 때문이다.
본 연구에서 도출된 두 원형 체형이 기존 노인 체형 연구에서 보고된 직통형·Abdominal-Protrusion Type 개념과 방향성에서 일치한다는 점은, 1,381명 규모의 대표성 있는 표본에서 기존 소규모 연구의 결과가 재현되었음을 의미한다. 다만 본 연구는 군집 방법 간 비교와 통계적 변수 검증을 결합했다는 점에서 단순 유형 분류에 머문 선행 연구와 구별되며, 어떤 변수가 그러한 체형 구분을 만들어 내는지를 정량적으로 제시했다는 점에서 차별성을 가진다.
실용적 관점에서 두 원형 체형과 Transitional Type의 구분은 노인 대상 제품·서비스 설계에 차별화된 기준을 제공할 수 있다. 예컨대 Abdominal-Protrusion Type은 허리·복부 여유분을 고려한 의류 설계와 대사 위험 관리가 동시에 요구되는 반면, Lower-Risk/Preserved-Limb Type은 상대적으로 보존된 하지 근력을 유지·강화하는 방향의 개입이 적합하다. 위험도가 혼재된 Transitional Type은 정기적 모니터링과 조기 선별의 우선 대상이 될 수 있다.
4-3 Autoencoder의 가능성과 한계
Autoencoder는 군집 성능(실루엣=0.275) 면에서 DBSCAN과 K-means보다 낮은 결과를 보였다. 그러나 Autoencoder의 잠재 공간(그림 6)에서 두 원형 체형의 분리 패턴이 시각적으로 확인되어, 딥 임베디드 군집화(DEC)[19] 알고리즘이 향후 적용 가능한 대안이 된다. 한편 근감소성 비만(Sarcopenic Obesity)[20]이 Transitional Type 집단에서 두드러질 가능성이 존재한다.
Autoencoder learning curve (left) and prototype body type distribution in latent space (right)
Autoencoder가 군집 평가 지표에서 상대적으로 낮은 성능을 보인 것은 알고리즘의 결함이라기보다, 입력을 충실히 복원하도록 학습하는 비지도 재구성 목표와 군집 경계를 뚜렷하게 분리하려는 목표가 서로 다른 방향을 향할 수 있기 때문으로 해석된다. 다만 이는 가설 수준의 설명이며, 이를 검증하려면 잠재 차원 변화에 따른 재구성 오차와 군집 성능의 관계, 그리고 재구성과 군집화를 함께 최적화하는 DEC 적용 결과를 근거로 제시할 필요가 있다. 재구성 중심으로 학습된 잠재 공간은 데이터의 전반적 분산을 보존하는 데 유리하지만, 군집 간 경계를 의도적으로 벌리지는 않는다. 그럼에도 불구하고 잠재 공간에서 두 원형 체형의 분포가 시각적으로 분리되어 나타났다는 점은, 군집 구조 자체가 자료에 내재해 있음을 방증한다. 따라서 재구성과 군집화를 동시에 최적화하는 딥 임베디드 군집화(DEC) 계열의 방법을 적용한다면, 본 연구에서 확인된 체형 구조를 보다 선명하게 분리해 낼 수 있을 것으로 기대된다.
방법론적으로 본 연구는 단일 군집 방법의 결과를 제시하는 데 그치지 않고, 원리가 상이한 다섯 가지 방법을 동일한 자료와 동일한 조건에서 비교했다는 점에서 의의가 있다. 이러한 비교는 특정 방법이 우연히 산출한 군집 구조를 일반적 사실로 오인하는 위험을 줄이고, 노인 체형이 연속적으로 분포한다는 자료의 본질적 특성을 드러내는 데 기여하였다.
특히 Transitional Type 집단은 근감소성 비만의 관점에서 주목할 만하다. 근육 감소와 지방 증가가 동시에 진행되는 이 상태는 두 원형 체형의 특성을 부분적으로 공유하므로, 자료 상에서 명확한 군집으로 분리되지 않고 경계 영역에 분포할 가능성이 높다. 이는 Transitional Type이 단순한 측정상의 잡음이 아니라, 임상적으로 가장 주의가 필요한 위험 집단을 내포할 수 있음을 시사한다.
종합하면, 본 연구의 결과는 노인 체형이 소수의 이산적 유형이라기보다 두 원형을 양극으로 하는 연속체에 가깝다는 일관된 그림을 제시한다. 이러한 관점은 기존의 범주형 체형 분류를 대체하기보다, 각 개인이 원형으로부터 얼마나 떨어져 있는지를 함께 표현하는 보완적 틀로 발전될 수 있다.
4-4 연구의 한계 및 향후 과제
본 연구는 몇 가지 한계를 가진다. 첫째, 분석에 사용된 자료는 특정 시점에 수집된 횡단면 자료이므로, 개인의 체형이 노화에 따라 어떻게 변화하는지를 직접 추적할 수 없다. 따라서 연령대별 차이는 동일 개인의 시간적 변화가 아니라 서로 다른 출생 코호트 간 차이를 일부 반영할 가능성이 있다. 둘째, 건강 위험은 Abdominal Obesity, Sarcopenia Risk, 하체 근육 부족을 결합한 복합 점수로 간접 평가되었으며, 임상적 진단이나 생화학적 지표를 직접 포함하지는 않았다. 셋째, 도출된 원형 체형은 탐색적으로 식별된 것으로, 독립된 별도 표본을 통한 외적 타당성 검증이 추가로 요구된다. 넷째, DBSCAN은 표본의 상당 부분(설정에 따라 49~74%)을 노이즈로 분리하므로 도출된 원형 체형은 밀도 핵심부에 한정되며, 노이즈 비율과 매개변수 선택에 민감하다. 다섯째, 군집 방법에 따라서는 성별 더미의 포함 여부가 군집 구성에 영향을 미쳤다. 다만 최종 원형 체형은 성별 더미를 제외한 입력에서 도출되었으므로 성별 변수에 의한 인위적 분할 가능성은 배제되며, 관찰된 성별 편중은 체형 자체의 성차에서 비롯된 것으로 해석된다. 잔여 한계는 본 연구가 성별을 층화 변수로 분리하지 않고 전체 표본을 통합하여 군집화하였다는 점이며, 성별 층화 군집 분석은 후속 과제로 남는다. 여섯째, 종속 변수인 복합 위험 점수가 WHtR·하지 비율에서 파생된 요소를 포함하므로 이를 예측한 회귀 결과는 순환성을 내포하며, 파생 관계가 없는 독립적 임상·생화학 지표에 의한 외적 검증이 필요하다.
향후 연구에서는 종단 자료를 활용하여 체형 전환의 경로를 추적하고, 임상·생화학 지표를 결합하여 각 원형 체형의 건강 위험을 보다 직접적으로 검증할 필요가 있다. 또한 본 연구에서 가능성을 확인한 딥 임베디드 군집화와 같이 재구성과 군집화를 통합한 방법을 적용하고, 식별된 핵심 변수를 활용한 간이 선별 도구를 개발한다면, 노인 맞춤형 의류·복지 기기 설계와 건강 위험 조기 선별에 실질적으로 기여할 수 있을 것이다.
Ⅴ. 결 론
본 연구는 한국 노인 체형 표준화를 위한 기초 연구로서, 1,381명의 신체 계측 데이터를 활용하여 신체 비율 지표의 통계적 특성을 규명하고, 다양한 군집 방법의 비교를 통해 한국 노인 체형의 원형 구조를 탐색적으로 식별하였다.
첫째, 한국 노인 신체 비율 지표의 통계적 기초값을 확립하였다. Thigh/Crotch Height(r=0.548)와 Calf/Thigh(r=0.561)가 성별 체형 차이를 가장 뚜렷이 구분하는 핵심 지표로 확인되었으며, Shoulder Width/Height는 성별·연령과 무관한 안정적 비율임이 드러났다.
둘째, 군집 분석의 결과를 단순히 세 개의 대등한 군집으로 병렬 비교하지 않고, 그중 하나를 Transitional Type 체형으로 재해석함으로써 보다 명료한 체형 구조를 도출하였다. 이 접근은 한국 노인의 체형이 두 극단적 원형과 그 사이의 광범위한 연속적 분포로 존재한다는 점을 드러낸다.
셋째, 체형 분류에 활용할 주요 후보 지표를 다중 통계 기법으로 일관되게 확인하였다. 로지스틱 회귀(McFadden R2=0.456)에서 Thigh/Crotch Height와 Calf/Thigh가 복합 건강 위험과 가장 강하게 연관된 지표로 확인되었으며(종속 변수와의 파생 관계로 인해 정합성 확인의 성격을 가짐), 성별(OR=0.121)과 연령(OR=1.071/년)은 체형 층화 변수로서 유효함이 확인되었다.
위의 결과를 바탕으로 한국 노인 체형 분류 체계 수립을 위한 방법론적·통계적 기반을 제공할 수 있다. 특히 본 연구는 시각적으로 판단하기 쉬운 일반 성인 체형과 달리, 노인 체형은 외형만으로 건강 위험성을 판별하기 어렵다는 점에 주목한다. 다차원 신체 비율 지표 기반의 군집 분류를 통해 외형적으로 유사해 보이는 노인들 사이에서도 대사 위험도가 서로 다른 체형 유형을 객관적으로 식별하고 위험성을 제시할 수 있으며, 이는 향후 노인 맞춤형 건강 위험 조기 선별 체계 구축에 활용될 수 있다.
또한 본 연구는 단일 군집 방법에 의존하던 기존 접근에서 벗어나, 다섯 가지 군집 방법을 동일한 조건에서 비교하고 그 결과를 통계적 변수 검증과 결합했다는 점에서 방법론적 의의를 가진다. 특히 모든 표본을 강제로 분류하는 대신 밀도 핵심부를 원형 체형으로, 경계 영역을 Transitional Type으로 분리한 접근은 노인 체형의 연속적 분포 특성을 드러내는 동시에, 위험도가 모호한 집단을 별도로 식별할 수 있는 실용적 틀을 제공한다.
본 연구에서 확립한 신체 비율 지표의 통계적 기초값과 핵심 변수는 노인 맞춤형 의류 치수 체계, 복지 기기 및 생활 환경 설계 기준, 파라메트릭 3D 아바타와 가상 피팅의 노인 기준 체형 파라미터, 체형 기반 사이즈 추천, 그리고 외형만으로는 판별하기 어려운 건강 위험의 조기 선별 도구 개발에 활용될 수 있는 기초 자료가 될 수 있다. 다만 본 연구는 외적 검증이 이루어지지 않은 탐색적 군집 분석이므로, 실제 적용에 앞서 독립 표본과 임상 지표를 이용한 후속 검증이 요구된다. 향후 종단 자료와 임상 지표를 결합한 검증, 그리고 재구성과 군집화를 통합한 딥러닝 기법의 적용을 통해, 본 연구의 결과가 보다 정교한 한국 노인 특화 체형 분류 체계로 발전할 수 있을 것으로 기대된다.
References
-
K. W. Kim and O. S. Kim, “Super Aging in South Korea Unstoppable but Mitigatable: A Sub-National Scale Population Projection for Best Policy Planning,” Spatial Demography, Vol. 8, No. 2, pp. 155-173, 2020.
[https://doi.org/10.1007/s40980-020-00061-8]

-
S. H. Yoon, K.-T. Han, S. J. Kim, T. Y. Sohn, B. Jeon, W. Kim, and E.-C. Park, “Combined Effect of Body Mass Index and Body Size Perception on Metabolic Syndrome in South Korea: Results of the Fifth Korea National Health and Nutrition Examination Surveys (2010-2012),” BMC Public Health, Vol. 15, No. 1, 554, 2015.
[https://doi.org/10.1186/s12889-015-1839-6]
-
L. K. Chen, J. Woo, P. Assantachai, T.-W. Auyeung, M.-Y. Chou, K. Iijima, ... and H. Arai, “Asian Working Group for Sarcopenia: 2019 Consensus Update on Sarcopenia Diagnosis and Treatment,” Journal of the American Medical Directors Association, Vol. 21, No. 3, pp. 300-307, 2020.
[https://doi.org/10.1016/j.jamda.2019.12.012]
-
A. J. Cruz-Jentoft, G. Bahat, J. Bauer, Y. Boirie, O. Bruyère, T. Cederholm, ... and M. Zamboni, “Sarcopenia: Revised European Consensus on Definition and Diagnosis,” Age and Ageing, Vol. 48, No. 1, pp. 16-31, 2019.
[https://doi.org/10.1093/ageing/afy169]
-
J. D. Sorkin, D. C. Muller, and R. Andres, “Longitudinal Change in Height of Men and Women: Implications for Interpretation of the Body Mass Index: The Baltimore Longitudinal Study of Aging,” American Journal of Epidemiology, Vol. 150, No. 9, pp. 969-977, 1999.
[https://doi.org/10.1093/oxfordjournals.aje.a010106]
-
B. J. Lee and J. Y. Kim, “Identification of Hemoglobin Levels Based on Anthropometric Indices in Elderly Koreans,” PLoS ONE, Vol. 11, No. 11, e0165622, 2016.
[https://doi.org/10.1371/journal.pone.0165622]
-
D. D. Pham, J. H. Lee, K. Y. Kim, J. Y. Song, J. E. Kim, and C. H. Leem, “Anthropometry-Based Estimation of Body Heat Capacity in Individuals Aged 7-69 Years: The Size Korea Survey 2010,” Scientific Reports, Vol. 8, No. 1, 2490, 2018.
[https://doi.org/10.1038/s41598-018-20872-6]
- J. B. MacQueen, “Some Methods for Classification and Analysis of Multivariate Observations,” in Proceedings of the 5th Berkeley Symposium on Mathematical Statistics and Probability, Vol. 1, Berkeley: CA, pp. 281-297, 1967. https://projecteuclid.org/euclid.bsmsp/1200512992
-
L. Duan, L. Xu, F. Guo, J. Lee, and B. Yan, “A Local-Density Based Spatial Clustering Algorithm with Noise,” Information Systems, Vol. 32, No. 7, pp. 978-986, 2007.
[https://doi.org/10.1016/j.is.2006.10.006]
-
G. E. Hinton and R. R. Salakhutdinov, “Reducing the Dimensionality of Data with Neural Networks,” Science, Vol. 313, No. 5786, pp. 504-507, 2006.
[https://doi.org/10.1126/science.1127647]
-
P. J. Rousseeuw, “Silhouettes: A Graphical Aid to the Interpretation and Validation of Cluster Analysis,” Journal of Computational and Applied Mathematics, Vol. 20, pp. 53-65, 1987.
[https://doi.org/10.1016/0377-0427(87)90125-7]
-
S. Im and H.-J. Lim, “A Framework for Embedding and Clustering Product Review Texts with Cluster Interpretation Using Large Language Models,” Journal of Digital Contents Society, Vol. 26, No. 6, pp. 1579-1587, 2025.
[https://doi.org/10.9728/dcs.2025.26.6.1579]
-
E. Schubert, J. Sander, M. Ester, H.-P. Kriegel, and X. Xu, “DBSCAN Revisited, Revisited: Why and How You Should (Still) Use DBSCAN,” ACM Transactions Database Systems, Vol. 42, No. 3, pp. 1-21, 2017.
[https://doi.org/10.1145/3068335]
-
M. Ashwell, P. Gunn, and S. Gibson, “Waist-to-Height Ratio Is a Better Screening Tool than Waist Circumference and BMI for Adult Cardiometabolic Risk Factors,” Obesity Reviews, Vol. 13, No. 3, pp. 275-286, 2012.
[https://doi.org/10.1111/j.1467-789X.2011.00952.x]
-
L. M. Browning, S. D. Hsieh, and M. Ashwell, “A Systematic Review of Waist-to-Height Ratio as a Screening Tool for the Prediction of Cardiovascular Disease and Diabetes: 0·5 Could Be a Suitable Global Boundary Value,” Nutrition Research Reviews, Vol. 23, No. 2, pp. 247-269, 2010.
[https://doi.org/10.1017/S0954422410000144]
-
S.-H. Park, S.-J. Choi, K.-S. Lee, and H.-Y. Park, “Waist Circumference and Waist-to-Height Ratio as Predictors of Cardiovascular Disease Risk in Korean Adults,” Circuation Journal, Vol. 73, No. 9, pp. 1643-1650, 2009.
[https://doi.org/10.1253/circj.CJ-09-0161]
-
M. Guasch-Ferré, M. Bulló, M. Á. Martínez-González, D. Corella, R. Estruch, M.-I. Covas, ... and J. Salas-Salvadó, “Waist-to-Height Ratio and Cardiovascular Risk Factors in Elderly Individuals at High Cardiovascular Risk,” PLoS ONE, Vol. 7, No. 8, e43275, 2012.
[https://doi.org/10.1371/journal.pone.0043275]
-
R. Sundareswaran, J. Herrera-Gerena, J. Just, and A. Jannesari, “Cluster Analysis with Deep Embeddings and Contrastive Learning,” arXiv:2109.12714, , 2021.
[https://doi.org/10.48550/arXiv.2109.12714]
-
E. Eskandarnia, H. M. Al-Ammal, and R. Ksantini, “An Embedded Deep-Clustering-Based Load Profiling Framework,” Sustainable Cities and Society, Vol. 78, 103618, 2022.
[https://doi.org/10.1016/j.scs.2021.103618]
-
M. Zamboni, G. Mazzali, F. Fantin, A. Rossi, and V. Di Francesco, “Sarcopenic Obesity: A New Category of Obesity in the Elderly,” Nutrition, Metabolism and Cardiovascular Diseases, Vol. 18, No. 5, pp. 388-395, 2008.
[https://doi.org/10.1016/j.numecd.2007.10.002]
-
S. Correia, P. Guimarães, and T. Zylkin, “Verifying the Existence of Maximum Likelihood Estimates for Generalized Linear Models,” Econometric Reviews, pp. 1-53, 2026.
[https://doi.org/10.1080/07474938.2026.2673989]
-
D. E. Giles, H. Feng, and R. T. Godwin, “On the Bias of the Maximum Likelihood Estimator for the Two-Parameter Lomax Distribution,” Communications in Statistics - Theory and Methods, Vol. 42, No. 11, pp. 1934-1950, 2013.
[https://doi.org/10.1080/03610926.2011.600506]
저자소개
2015년:동국대학교 응용통계학과(이학사)
2021년:동국대학교 산업시스템공학과(공학박사)
2023년~2026년 8월: 강원대학교 첨단 AI공학과 조교수
2026년 9월~현 재: 강원대학교 첨단AI공학과 부교수
※관심분야:머신러닝(Machine Learning), 딥러닝(Deep Learning), 헬스케어(Healthcare), 데이터 분석(Data Analysis) 등
2013년:중앙대학교 대학원 컴퓨터공학과 석사
2019년:중앙대학교 대학원 컴퓨터공학과 박사
2022년~2026년 8월: 강원대학교 첨단 AI공학과 조교수
2026년 9월~현 재: 강원대학교 첨단AI공학과 부교수
※관심분야:컴퓨터 비전(Computer Vision), 감성 컴퓨팅(Emotional Computing), 인공지능(Artificial Intelligence)